Che l’IA nel PLM e nell’engineering abbia bisogno di regole si è ormai capito. Si tratta di accessi ai dati, responsabilità, approvazioni, evidenze e della domanda su quali compiti un sistema possa assumersi. E alla fine è sempre una persona a dover rispondere delle conseguenze.
Vorrei aggiungere qualcosa a questo punto importante: l’IA nell’engineering non ha bisogno solo di regole, ma anche di fiducia.
Non lo dico in tono sarcastico. E non è nemmeno un invito a concedere all’IA un credito di fiducia a priori. Qui la fiducia è intesa in modo del tutto costruttivo: come condizione perché l’IA possa esprimere il suo valore. Chi non riesce ad affidare a un’IA nessun compito e nessun margine d’azione finisce forse con un sistema ben protetto, ma probabilmente senza aver guadagnato nulla.
Allo stesso tempo, la fiducia non nasce da una decisione. Non si può imporre con una direttiva, né sostituire facendo confermare ogni singola azione da una persona. La fiducia deve svilupparsi: attraverso un impegno attivo con l’IA, una sperimentazione limitata, l’osservazione dei suoi risultati e una comprensione crescente delle sue capacità e dei suoi limiti.
La vera domanda manageriale non è quindi solo: Quali regole servono all’IA? È anche: Per cosa, a quali condizioni e con quali conseguenze siamo disposti a fare affidamento su di essa?
Questo è particolarmente concreto nell’engineering: se un’IA riassume una riunione sui requisiti, segnala una contraddizione o cerca componenti simili, un errore è quasi sempre(!) solo fastidioso, ma gestibile. Se la stessa IA modifica una distinta base già approvata, formula un’affermazione di compliance o avvia un processo di modifica che arriva fino alla produzione, la situazione è diversa.
La fiducia non è carta bianca
«Fidarsi è bene, controllare è meglio» è facile da dire e suona giusto. La frase contiene in effetti un nucleo importante: i risultati non dovrebbero essere accettati senza verifica. Nel rapporto con l’IA, però, diventa fuorviante se il controllo viene equiparato alla verifica di ogni singolo passaggio di lavoro.
Perché il controllo integrale di ogni singola azione non è scalabile. Chi conferma ogni azione dell’IA singolarmente non crea automaticamente più sicurezza. Con l’aumentare del numero di decisioni, aumentano il rischio di pressione temporale, abitudine e stanchezza da approvazione. La ricerca sull’automation bias descrive esattamente questo effetto: chi lavora con un sistema automatizzato controlla i suoi output con minore attenzione nel tempo e non si accorge di errori che, senza l’automazione, sarebbero stati notati. Alla fine si rischia di confermare senza accorgersene esattamente ciò che si voleva controllare con cura.
Il controllo, quindi, non è gratuito. Costa tempo, attenzione e capacità decisionale. E può diventare esso stesso un rischio, se interviene nei punti sbagliati.
La fiducia cieca, però, non è un’alternativa. Un output formulato in modo plausibile (da cui il termine inglese AI slop) non è ancora un risultato solido. Un’IA può risultare convincente anche se le manca il contesto, i dati sono collegati in modo errato o sta affrontando un compito fuori dal suo ambito di applicazione adeguato.
La domanda decisiva non è quindi: Ci fidiamo dell’IA? Ma: Per cosa, a quali condizioni e con quali conseguenze siamo disposti a fare affidamento su di essa?
La fiducia significa delegare in condizioni di incertezza
Nella ricerca sulla fiducia, la fiducia non viene intesa come la certezza che l’altra parte si comporterà correttamente. Significa piuttosto la disponibilità a impegnarsi con un’altra parte in condizioni di incertezza e nonostante una certa vulnerabilità. Mayer, Davis e Schoorman hanno descritto questa prospettiva in modo fondamentale per le organizzazioni.
Per l’impiego dell’automazione è importante una distinzione simile: l’obiettivo non è la massima fiducia possibile, ma un’aspettativa di affidabilità adeguata. Lee e See parlano in questo contesto di appropriate reliance: le persone dovrebbero fare affidamento sull’automazione quando è adatta a un compito – e al tempo stesso restare in grado di osservarne i risultati, di metterli in discussione o di respingerli.
Questo può sembrare astratto, ma nell’engineering diventa subito concreto. La fiducia in un’IA non è globale. Non si tratta di: «Ci fidiamo di questo modello». Si tratta piuttosto di:
Ci fidiamo di questo sistema per questo compito, con questi dati, in questo processo e all’interno di questi limiti.
Per questo sono decisive almeno tre domande:
Capacità. L’IA riesce a svolgere questo compito concreto in modo sufficientemente buono?
Affidabilità. Lavora in modo coerente in condizioni comparabili e all’interno del quadro previsto?
Idoneità allo scopo. Questo sistema è adatto allo scopo per cui lo utilizziamo?
È proprio quest’ultimo punto a essere sottovalutato. Un’IA generica può essere utile per molti compiti. Ma da questo non consegue che sia adatta a ogni compito. Un sistema che riassume bene i testi non è automaticamente un sistema che dovrebbe modificare dati di prodotto approvati.
Un’IA non possiede un carattere nel senso umano del termine né un proprio senso di responsabilità. Ma non è nemmeno un’istanza completamente neutrale. Dati di addestramento, comportamento del modello, istruzioni di sistema e contesto fornito influenzano come risponde, cosa priorizza, cosa omette e come gestisce l’incertezza. Questo «atteggiamento» non è personalità. Resta comunque rilevante per capire se il sistema è adatto allo scopo e alle regole dell’azienda.
La fiducia nasce dall’impegno attivo
Mi piace usare questa analogia: Con un nuovo collaboratore o un nuovo team, all’inizio non si sa ancora bene cosa aspettarsi. Si conosce il CV o la descrizione del team. Ma non si conoscono le competenze per esperienza diretta. Non si sa come qualcuno reagisce a requisiti poco chiari, pressione di tempo o errori. Per questo la collaborazione inizia di solito con compiti limitati, domande di chiarimento, osservazione e feedback.
Con il tempo si forma un quadro: cosa sa fare questa persona? Dove lavora in modo affidabile? Quando ha bisogno di supporto? Quale responsabilità può assumersi? Quando questo quadro diventa più stabile, il controllo capillare può diminuire.
L’analogia del nuovo collaboratore aiuta anche nel rapporto con l’IA. Ha però un limite importante: un collaboratore adeguato può capire le regole, fare domande, imparare dall’esperienza e adattare il proprio comportamento a nuove situazioni. Un’IA non lo fa automaticamente nello stesso modo. Il suo quadro di lavoro (e il ciclo di apprendimento) devono essere costruiti più intenzionalmente sul piano tecnico e organizzativo.
Per questo la fiducia nell’IA non nasce da una decisione, né da una presentazione sulle capacità dell’ultimo modello. Nasce dall’impegno attivo con il sistema concreto:
- assegnare compiti reali ma limitati;
- osservare risultati e pattern di errore;
- identificare contesti adatti e non adatti;
- confrontare le aspettative con le prestazioni effettive;
- adattare regole, prompt, accesso ai dati e verifiche;
- ampliare o ridurre l’autonomia.
Decisivo per il ciclo di apprendimento è il seguente circolo di controllo:
provare → osservare → valutare → limitare o ampliare → osservare di nuovo
La ricerca sulla fiducia descrive un percorso simile. Lewicki e Bunker distinguono una fiducia calcolata, basata su garanzie e sanzioni, da una fiducia che nasce da uno scambio ripetuto e da una prevedibilità osservata – e infine da una fiducia basata su valori condivisi e identificazione. Il terzo livello non è disponibile per l’IA. Proprio per questo il rapporto con l’IA resta permanentemente legato alla prevedibilità osservata: qui la fiducia non cresce da un’unica grande prestazione, ma da molte esperienze che stabilizzano un’aspettativa – e da condizioni che rendono possibile questa osservazione.
Questo ha una conseguenza immediata per le aziende: chi non si impegna attivamente con l’IA non può sviluppare una fiducia adeguata né definire limiti adeguati. Un’azienda che aspetta solo uno strumento o un modello migliore manca il vero compito di apprendimento. Un modello potente senza contesto sufficiente, dati affidabili e verifiche adatte è solo una via più rapida verso un risultato mal interpretato.
L’IA ha bisogno di un «campo di gioco» definito – non solo di un’approvazione
Questo campo di gioco si può osservare da due prospettive. Sul campo stesso c’è la domanda su come l’IA possa operare. Dal bordo del campo c’è la domanda su come l’organizzazione gestisca i suoi risultati.
La prima prospettiva si potrebbe definire quadro operativo e guardrail per l’IA. Ne fanno parte, tra l’altro:
- lo scopo e l’ambito di applicazione consentito;
- le fonti di dati e il contesto fornito;
- un modello informativo condiviso;
- strumenti e azioni consentiti e vietati;
- requisiti su fonti, forma e qualità dei risultati;
- soglie e blocchi tecnici;
- logging, versionamento e cicli di feedback.

I guardrail sono quindi più di semplici indicazioni nel system prompt. Un limite che l’agente stesso può superare o eludere non è un limite solido. Le restrizioni critiche dovrebbero quindi essere imposte, nella misura del possibile, fuori dal modello – ad esempio tramite diritti di accesso, soglie di approvazione fisse, API gateway o logica di processo.
Il secondo aspetto è l’architettura di supervisione e responsabilità dell’organizzazione. Qui deve essere chiaro:
- Chi è responsabile dal punto di vista tecnico?
- Chi può adottare o approvare un risultato?
- Quando l’IA deve fermarsi ed escalare?
- Quali risultati vengono solo osservati e quali verificati attivamente?
- Come viene rilevato, annullato e valutato un errore?
- Chi può aumentare un livello di autonomia – e chi può ridurlo di nuovo?
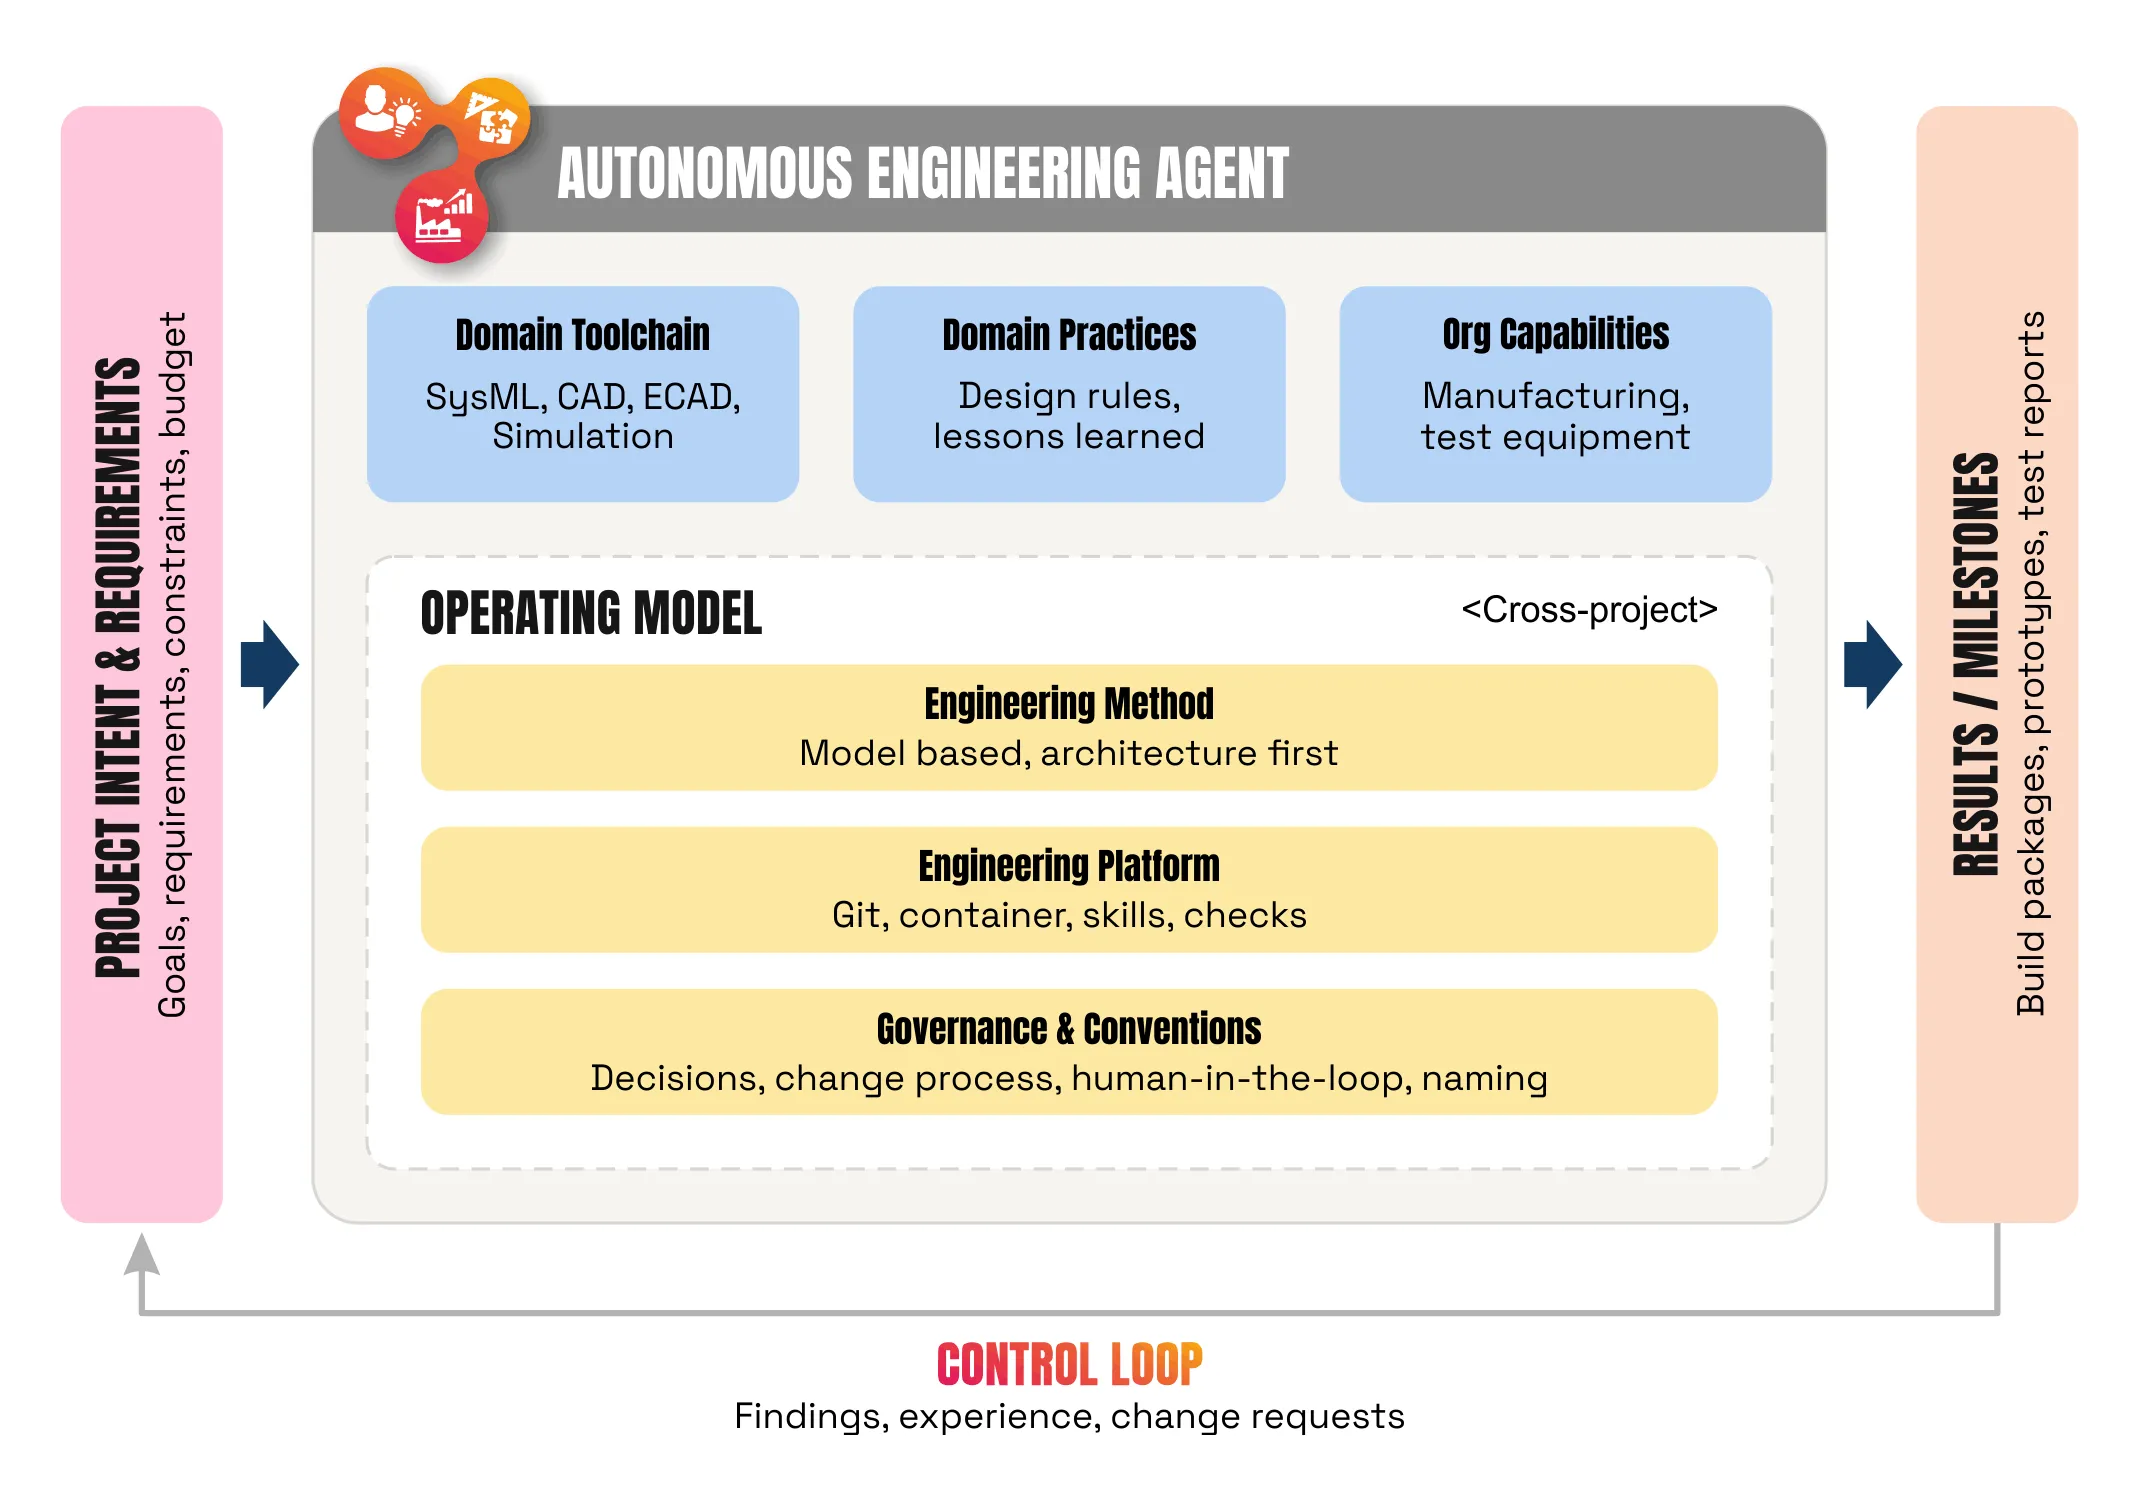
Governance e guardrail non sono quindi la stessa cosa. La governance definisce il quadro organizzativo: cosa è consentito, chi è responsabile e come viene monitorato. I guardrail traducono parti di questo quadro in restrizioni tecniche a runtime.

L’arte consiste nel non applicare lo stesso regime di controllo a ogni compito. Un semplice servizio di riassunto non dovrebbe seguire lo stesso processo di approvazione di un sistema che scrive su dati di prodotto critici per la sicurezza. Il MIT Center for Information Systems Research (van der Meulen, Jewer, Levallet) propone a questo scopo il termine minimum viable governance: tanta governance quanta è necessaria per limitare efficacemente il rischio. Oltre una certa soglia, secondo il gruppo di ricerca, la governance frena più di quanto protegga – le decisioni si accumulano e l’opportunità reale sfuma.
Questo non vuole essere un invito a meno governance, ma certamente alla governance giusta.
La responsabilità richiede comprensione – ma non di ogni dettaglio tecnico
Una governance graduata significa anche: non ogni azione dell’IA finisce sotto esame. E con ciò emerge subito un’obiezione. Se i responsabili non devono seguire ogni singolo passaggio dell’IA, come possono allora assumersi la responsabilità?
La risposta sta in una distinzione più precisa del concetto di «comprensione». Per una supervisione responsabile occorre distinguere almeno quattro livelli:
- Comprensione di contenuto: Cosa significa il risultato per prodotto, processo e decisione?
- Comprensione del processo: Con quali dati, regole, contesti, verifiche e approvazioni è nato il risultato?
- Comprensione del rischio: Cosa potrebbe succedere se il risultato fosse errato, incompleto o fuori dal suo ambito di validità?
- Comprensione tecnica di dettaglio: Come si può ricostruire ogni singolo passaggio interno di elaborazione del modello?
I primi tre livelli sono di regola indispensabili per decisioni responsabili. Il quarto può essere rilevante in casi particolari, ma non va equiparato alla responsabilità ed è comunque raggiungibile solo in misura limitata nei processi complessi.
Anche l’EU AI Act non richiede, per la supervisione umana sui sistemi IA ad alto rischio, che ogni calcolo interno del modello possa essere completamente ricostruito. L’art. 14 punta su altro: che le persone incaricate della supervisione comprendano adeguatamente le capacità e i limiti del sistema, affrontino consapevolmente l’automation bias e siano in grado di inquadrare, scartare o correggere i risultati. Il comma 3 richiede inoltre espressamente di orientare la supervisione al rischio, al grado di autonomia e al contesto d’uso – quindi esattamente la proporzionalità di cui si parla qui.
«La comprensione tecnica di dettaglio non è sempre necessaria» non può quindi significare che la comprensione tecnica di merito sia superflua. Una persona che può solo cliccare su un pulsante di approvazione, ma non è in grado di valutare l’affermazione, il processo che l’ha generata e il danno potenziale, non esercita una supervisione efficace. È presente nel processo solo formalmente.
Il problema viene spesso descritto come rubber-stamping: la persona resta nominalmente nel ciclo di controllo, ma diventa di fatto chi approva automaticamente. Il controllo sistemico è quindi responsabile solo se è legato a una vera comprensione del processo e del rischio. L’EU AI Act chiama in causa a questo scopo i gestori – l’art. 26, comma 2, richiede di affidare la supervisione a persone che dispongano della competenza, della formazione e dell’autorità necessarie.
L’engineering controlla da sempre i passaggi di consegna, non ogni singolo passo di pensiero
La comprensione del processo e del rischio non va quindi applicata ovunque con la massima profondità, ma nei punti decisivi. L’engineering compie questa scelta consapevolmente da sempre: i buoni processi di sviluppo non controllano ogni singola attività di un progettista, di un gruppo di progetto o di un fornitore (anche se questo accade, spesso per motivi economici e di controlling). Pongono punti di controllo dove cambia il rischio, la responsabilità o lo stato di un risultato.
Design review, verifica e validazione, FMEA, approvazioni e quality gate perseguono esattamente questo scopo. Non verificano ogni ragionamento che ha portato a un risultato (eccezione: settori particolarmente regolamentati). Verificano se il risultato soddisfa i requisiti, se i rischi rilevanti sono stati considerati e se sono disponibili le evidenze necessarie.
Anche qui vale la stessa analogia: la teoria organizzativa e del controllo distingue tra controllo comportamentale e controllo dei risultati. La distinzione risale a Ouchi; Eisenhardt la collega alla teoria dell’agenzia. Il controllo comportamentale è utile quando chi controlla comprende il processo che trasforma un input in un output. Il controllo dei risultati è utile quando i risultati possono essere descritti e valutati chiaramente.
In un grande modello di IA, un controllo completo del processo interno di elaborazione non è di norma una base realistica per la responsabilità. Questo non significa che non si possa controllare nulla. Significa che il controllo deve essere spostato altrove: su contesto, dati, regole, evidenze, qualità dei risultati e passaggi di consegna.
La governance PLM per l’IA non deve quindi partire da zero. Può collegarsi alle logiche esistenti di lifecycle, approvazione e change. Allo stesso tempo l’IA costringe a verificare l’effettivo impatto di rischio di questi processi. Un processo di change già lento e burocratico non diventa automaticamente migliore con ulteriori approvazioni singole.
Il grado di autonomia deve correlare con il rischio
Se il controllo deve intervenire nei passaggi di consegna rilevanti, l’organizzazione deve decidere quanto controllo serva a ciascun passaggio. Per questo serve un criterio che vada oltre la semplice domanda «IA o non IA?».
Metodi in questo senso esistono da tempo: la FMEA, ad esempio, valuta un rischio di errore attraverso tre grandezze: gravità (quanto pesa l’effetto dell’errore?), probabilità di accadimento (quanto è probabile che si verifichi?) ed individuazione (quanto è probabile che venga notato in anticipo?). Il sistema più vecchio moltiplicava questi valori nel numero di priorità di rischio (RPN); la FMEA armonizzata AIAG-VDA del 2019 lo sostituisce con una priorità d’azione (AP). La sicurezza funzionale lavora con un insieme correlato, ma suddiviso diversamente: la ISO 26262 deriva il livello di sicurezza necessario (ASIL) da gravità, frequenza della situazione operativa e controllabilità. La controllabilità è particolarmente istruttiva per la questione della delega – la situazione può ancora essere recuperata se l’errore si verifica? La prendo in prestito come quarta domanda rispetto alle tre grandezze della FMEA.
Queste grandezze (le tre della FMEA, integrate dalla controllabilità della sicurezza funzionale) si prestano come criterio per stabilire quanta autonomia può sostenere un compito affidato all’IA.
Gravità/Impatto
Quanto si propaga un errore in prodotto, processo e organizzazione – resta nella progettazione, oppure si estende fino ad approvvigionamento, produzione, omologazione o comunicazione con il cliente?
Probabilità di accadimento
Diventa la domanda sulla qualità del contesto e la stabilità dei risultati: il sistema ha le informazioni giuste – e produce quindi risultati riproducibili?
Probabilità di individuazione
Esiste un ciclo di controllo (umano o automatico) in grado di rilevare gli errori, e se sì quanto è affidabile? Una cricca in una saldatura è una cricca in una saldatura. Un paragrafo errato di un testo generato dall’IA si legge come se fosse corretto.
Controllabilità
Diventa in larga misura la domanda sulla reversibilità: un’azione indotta dall’IA può essere completamente annullata, e in tutti i sistemi in cui si è già propagata?
Per la combinazione di propagazione e reversibilità circola, nella discussione pratica sugli agenti IA, anche il termine raggio del danno (in inglese blast radius, preso in prestito dall’operatività IT e cloud, dove è già di per sé una metafora presa dall’analisi degli effetti di un’esplosione): l’estensione del danno che una decisione sbagliata può provocare prima che qualcuno la intercetti. La regola pratica che ne deriva – la supervisione deve crescere insieme al raggio del danno – proviene dal blog di un fornitore di strumenti per agenti di coding. Il concetto non sostituisce la logica della FMEA, ma può integrarla.
Autonomia non dovrebbe quindi essere definita in modo generico per un modello o un agente. È una decisione progettuale consapevole, non una conseguenza automatica delle capacità crescenti del modello. Questo si ritrova in diversi framework sull’autonomia, dai livelli di autonomia del Knight First Amendment Institute al modello a livelli di autonomia della Cloud Security Alliance. Per un compito l’IA può fare proposte, per un altro preparare analisi e per un terzo agire autonomamente entro limiti rigidi.
Una gradazione pragmatica potrebbe essere la seguente:
| Livello | Denominazione | Cosa può fare l’IA |
|---|---|---|
| 01 | Proporre | L’IA genera bozze, riassunti, classificazioni o risultati di ricerca. L’uso successivo resta fuori dall’IA e viene deciso dalle persone. |
| 02 | Preparare e informare | L’IA collega informazioni, analizza impatti o compila dati di modifica. Influenza una decisione, ma non la avvia da sola. |
| 03 | Eseguire entro limiti rigidi | L’IA può avviare un’azione da sola, se ambito, accesso ai dati, soglie, protocollazione, revoca ed escalation sono regolati chiaramente. |
Questi livelli non sono una norma rigida. In base all’azienda e al caso d’uso, livelli più sfumati possono essere opportuni.
Fare dell’IA una questione di vertice – ma non di burocrazia
Criteri di questo tipo non si possono imporre con una direttiva. Chi li traduce in un modulo ottiene un modulo, non un giudizio migliore su quanta autonomia possa sostenere un compito. Questo giudizio nasce nell’organizzazione, e per questo servono alcune linee guida a livello di leadership.
Primo: l’IA deve diventare un compito di apprendimento condiviso. Non è solo un tema IT, di dati o di compliance. Engineering, aree specialistiche, qualità, IT e leadership devono sviluppare una comprensione comune di cosa sa fare il sistema, dove fallisce e quali conseguenze avrebbe un errore. Per questo serve un impegno pratico con compiti reali. Le applicazioni a basso rischio non sono quindi solo strumenti di produttività, ma campi di apprendimento. Aiutano a calibrare le aspettative, a riconoscere pattern di errore e a fondare la fiducia su esperienze solide.
Secondo: deve essere permesso sperimentare. Un’azienda che tratta ogni esperimento come un’introduzione critica per la produzione imparerà solo lentamente – o, peggio, lo farà scavalcando la governance ufficiale. Una governance eccessiva e inadeguata può favorire la Shadow AI: le persone cercano la via più rapida e non ufficiale, sottraendo così l’impiego proprio al controllo previsto. Sperimentare, però, non significa ignorare i rischi. Significa limitare gli esperimenti in modo che l’organizzazione possa imparare senza generare conseguenze incontrollabili.
Terzo: l’autonomia deve essere legata a evidenze. Non deve essere la valutazione generica «ormai ci fidiamo del sistema» a decidere su un livello di autonomia più alto. Ciò che conta sono evidenze concrete: per quale compito i risultati sono solidi? A quali condizioni? Quali errori vengono rilevati? Con quale rapidità si può intervenire o tornare indietro? Chi decide sull’innalzamento e sull’abbassamento del livello?
Quarto: i processi di engineering esistenti non dovrebbero essere semplicemente estesi, ma verificati o persino ripensati. L’introduzione dell’IA è un’occasione per chiedersi se i gate esistenti intervengano davvero sui rischi rilevanti. Se si aggiunge un’ulteriore approvazione per ogni azione dell’IA a un processo di change già sovraccarico, si aumenta solo la burocrazia – non la sicurezza.
La fiducia è il risultato di buone condizioni
L’IA potrà esprimere pienamente il suo valore nell’engineering solo quando le aziende le concederanno non solo compiti, ma anche un margine d’azione adeguato. Questo margine d’azione non deve nascere dall’euforia né essere bloccato dalla paura.
E: la fiducia nell’IA non è un interruttore on/off. È specifica per compito, basata sull’osservazione e revocabile. Cresce quando un’azienda si confronta attivamente con l’IA, ne conosce le capacità e i limiti e trae conseguenze dai suoi risultati.
Per questo servono un buon contesto, linee guida chiare, punti di controllo rilevanti, risultati visibili, responsabilità chiarite e una possibilità funzionante di abbassamento del livello.
Chi si limita a controllare, senza imparare, resta prigioniero di un controllo capillare. Chi si limita a fidarsi, senza osservare, confonde la speranza con la governance.
Il futuro dell’engineering non sta quindi né nel controllo totale dell’IA né nella sua autonomia completa. Sta nella capacità di concederle margine d’azione esattamente dove le persone ne hanno compreso le prestazioni, i limiti e le conseguenze di un errore.
Domande e risposte
Perché l’IA nell’engineering ha bisogno non solo di regole, ma anche di fiducia?
Perché un’IA esprime il suo pieno valore solo quando le vengono affidati un compito e un margine d’azione. Chi fa approvare ogni singola azione finisce con un sistema ben protetto – ma con poco guadagnato. La fiducia non è un credito a priori, ma la disponibilità motivata a fare affidamento sul sistema per un compito concreto in condizioni di incertezza.
Qual è la differenza tra governance dell’IA e guardrail?
La governance è il quadro organizzativo: cosa è consentito, chi è responsabile dal punto di vista tecnico, chi approva, come viene monitorato. I guardrail traducono parte di questo quadro in restrizioni tecniche a runtime – diritti di accesso, soglie, API gateway, logica di processo. Decisivo: un limite che l’agente stesso può superare non è un limite. Le restrizioni critiche vanno imposte fuori dal modello.
Quanta autonomia dovrebbe avere un’IA nel PLM e nell’engineering?
Tanta quanta può sostenerne il singolo compito – l’autonomia viene assegnata per compito, non in modo generico per modello. Tre livelli danno un orientamento: proporre (l’IA genera bozze, le persone decidono sull’uso), preparare e informare (l’IA collega informazioni e analizza impatti, ma non avvia la decisione) ed eseguire entro limiti rigidi (l’IA agisce da sola, se ambito, accesso ai dati, protocollazione, revoca ed escalation sono regolati).
Come si valuta il rischio di un compito affidato all’IA?
Attraverso quattro domande tratte da metodi consolidati dell’engineering. Dalla FMEA: propagazione (quanto si estende un errore in prodotto, processo e organizzazione?), qualità del contesto (il sistema ha le informazioni giuste?) e osservabilità (l’errore viene notato prima che produca effetti?). A questo si aggiunge la controllabilità dalla sicurezza funzionale secondo la ISO 26262, qui intesa come reversibilità: l’azione può essere annullata in tutti i sistemi coinvolti? Propagazione e reversibilità insieme costituiscono il raggio del danno (blast radius) – e la supervisione deve crescere insieme a esso.
L’human-in-the-loop è sufficiente come supervisione sui sistemi IA?
No. Una persona presente nel processo non è ancora una supervisione efficace. Per questo deve ricevere le informazioni rilevanti, essere in grado di inquadrare il risultato nel merito, valutarne le conseguenze e poter effettivamente intervenire. Se mancano tempo, competenza o possibilità di revoca, si genera rubber-stamping – la persona resta nominalmente nel ciclo di controllo, ma diventa chi approva automaticamente. Il controllo integrale di ogni singola azione, al contrario, non aiuta: genera stanchezza da approvazione e quindi esattamente l’automation bias che dovrebbe prevenire.
Cosa richiede l’EU AI Act sulla supervisione umana dell’IA?
L’art. 14 non richiede, per i sistemi IA ad alto rischio, che ogni calcolo interno del modello sia ricostruibile. Viene richiesto che le persone incaricate della supervisione comprendano adeguatamente le capacità e i limiti del sistema, affrontino consapevolmente l’automation bias e siano in grado di inquadrare, scartare o correggere i risultati. Il comma 3 richiede di orientare la supervisione al rischio, al grado di autonomia e al contesto d’uso; l’art. 26, comma 2, obbliga i gestori ad affidarla a persone con la competenza, la formazione e l’autorità necessarie.
Troppa governance può ostacolare l’impiego dell’IA?
Sì. Il MIT Center for Information Systems Research lo riassume come minimum viable governance: tanta governance quanta è necessaria per limitare efficacemente il rischio. Oltre questo limite frena più di quanto protegga – le decisioni si accumulano, l’opportunità sfuma. Una governance inadeguata favorisce inoltre la Shadow AI: le persone si spostano sulla via non ufficiale, sottraendo l’impiego proprio al controllo previsto.