Que la IA en PLM e ingeniería necesita reglas ya se ha extendido como idea. Se trata de accesos a datos, responsabilidades, autorizaciones, evidencias y la pregunta de qué tareas puede asumir un sistema. Y al final, la responsabilidad debe recaer en una persona.
Me gustaría añadir algo a este punto importante: la IA en ingeniería no solo necesita reglas, también necesita confianza.
No lo digo con sarcasmo. Tampoco es un alegato para conceder a una IA un anticipo de confianza sin más. Aquí la confianza se entiende de forma constructiva: como condición para que la IA pueda desplegar su utilidad. Quien no puede confiarle a una IA ninguna tarea ni ningún margen de actuación acaba quizás con un sistema bien blindado, pero probablemente sin haber ganado nada.
Al mismo tiempo, la confianza no surge por decreto. No se puede imponer mediante una directriz, ni se puede sustituir exigiendo que cada acción individual sea confirmada por una persona. La confianza tiene que desarrollarse: mediante el trabajo activo con la IA, mediante pruebas acotadas, observando sus resultados y mediante una comprensión creciente de sus capacidades y sus límites.
Por eso, la verdadera pregunta de gestión no es solo: ¿qué reglas necesita la IA? También es: ¿para qué, bajo qué condiciones y con qué consecuencias estamos dispuestos a confiar en ella?
Esto se aprecia especialmente en ingeniería: si una IA resume una reunión de requisitos, marca una contradicción o busca piezas similares, un error suele (¡eso sí!) ser solo molesto, pero controlable. Si esa misma IA modifica una lista de materiales liberada, emite una afirmación de cumplimiento normativo o desencadena un proceso de cambio hasta la fabricación, la situación es otra.
La confianza no es un cheque en blanco
«Confianza está bien, control es mejor» se dice fácilmente y suena acertado. Al fin y al cabo, la frase contiene un núcleo importante: los resultados no deberían aceptarse sin comprobarlos. Pero en el trato con la IA induce a error en cuanto se equipara control con revisar cada paso de trabajo uno por uno.
Porque el control individual completo no escala. Confirmar cada acción de la IA una por una no genera automáticamente más seguridad. Cuantas más decisiones se acumulan, más amenazan la presión de tiempo, la habituación y la fatiga de aprobación. La investigación sobre el sesgo de automatización describe exactamente este efecto: quien trabaja con un sistema automatizado revisa sus resultados con menos rigor con el paso del tiempo y pasa por alto errores que, sin la automatización, habría detectado. Al final, se puede acabar aprobando sin verlo precisamente aquello que se quería revisar con más cuidado.
El control, por tanto, no es gratuito. Cuesta tiempo, atención y capacidad de decisión. E incluso puede convertirse en un riesgo si se aplica en los lugares equivocados.
Pero la confianza ciega tampoco es una alternativa. Un resultado formulado de forma convincente (la famosa AI slop) todavía no es un resultado fiable. Una IA puede resultar convincente aunque le falte contexto, enlace mal los datos o esté trabajando en una tarea fuera de su ámbito adecuado de aplicación.
Por eso, la pregunta decisiva no es: ¿confiamos en la IA? Sino: ¿para qué, bajo qué condiciones y con qué consecuencias estamos dispuestos a confiar en ella?
Confiar significa delegar bajo incertidumbre
En la investigación sobre la confianza, esta no se entiende como la certeza de que la otra parte se comportará correctamente. Más bien, confianza significa la disposición a involucrarse con otra parte bajo incertidumbre y pese a cierta vulnerabilidad. Mayer, Davis y Schoorman describieron esta perspectiva de forma determinante para las organizaciones.
Para el uso de la automatización es importante una distinción similar: el objetivo no es la mayor confianza posible, sino una expectativa de fiabilidad adecuada. Lee y See hablan en este contexto de appropriate reliance: las personas deben confiar en la automatización cuando esta es adecuada para una tarea, y a la vez seguir siendo capaces de observar, cuestionar o rechazar sus resultados.
Esto suena abstracto, pero en ingeniería se vuelve concreto enseguida. La confianza en una IA no es global. No dice: «confiamos en este modelo». Dice más bien:
Confiamos en este sistema para esta tarea, con estos datos, en este proceso y dentro de estos límites.
Para ello son decisivas al menos tres preguntas:
Capacidad. ¿Puede la IA cumplir esta tarea concreta con suficiente calidad?
Fiabilidad. ¿Trabaja de forma consistente en condiciones comparables y dentro del marco previsto?
Idoneidad para el fin. ¿Es este sistema adecuado para el propósito con el que lo empleamos?
Precisamente el último punto se subestima. Una IA genérica puede ser útil para muchas tareas. Pero de ahí no se deduce que sea adecuada para todas. Un sistema que resume bien textos no es automáticamente un sistema que deba modificar datos de producto liberados.
Una IA no tiene carácter en el sentido humano ni un sentido propio de responsabilidad. Pero tampoco es una instancia completamente neutral. Los datos de entrenamiento, el comportamiento del modelo, las instrucciones del sistema y el contexto proporcionado determinan cómo responde, qué prioriza, qué omite y cómo gestiona la incertidumbre. Esta “postura” no es personalidad. Aun así, es relevante para saber si el sistema encaja con el propósito y las reglas de la empresa.
La confianza surge del trabajo activo
Me gusta recurrir a la siguiente analogía: Con un nuevo empleado o un nuevo equipo, al principio no se sabe bien qué esperar. Se conoce el currículum o la descripción del equipo, pero no las capacidades por experiencia propia. No se sabe cómo alguien reacciona ante requisitos poco claros, presión de tiempo o errores. Por eso, la colaboración suele empezar con tareas acotadas, preguntas, observación y retroalimentación.
Con el tiempo se forma una imagen: ¿qué sabe hacer esta persona? ¿Dónde trabaja de forma fiable? ¿Cuándo necesita apoyo? ¿Qué responsabilidad puede asumir? A medida que esta imagen se estabiliza, el control al detalle puede reducirse.
La analogía del nuevo empleado también ayuda a tratar con la IA. Sin embargo, tiene un límite importante: un empleado adecuado puede entender reglas, hacer preguntas, aprender de la experiencia y adaptar su comportamiento a situaciones nuevas. Una IA no hace esto automáticamente de la misma manera. Su marco de trabajo (y el ciclo de aprendizaje) debe construirse de forma más deliberada, técnica y organizativamente.
Por eso, la confianza en la IA no surge de una decisión ni de una presentación sobre las capacidades del último modelo. Surge del trabajo activo con el sistema concreto:
- asignar tareas reales, pero acotadas;
- observar resultados y patrones de error;
- identificar contextos adecuados y no adecuados;
- contrastar las expectativas con el rendimiento real;
- ajustar reglas, prompts, acceso a datos y revisiones;
- ampliar o retirar autonomía.
Para el ciclo de aprendizaje es decisivo el siguiente bucle:
probar → observar → evaluar → limitar o ampliar → volver a observar
La investigación sobre la confianza describe un recorrido parecido. Lewicki y Bunker distinguen una confianza calculadora, que se apoya en garantías y sanciones, de una confianza que surge del intercambio repetido y la previsibilidad observada, y finalmente de una confianza basada en valores compartidos e identificación. La tercera etapa no está disponible para la IA. Precisamente por eso, el trato con la IA sigue dependiendo de forma permanente de la previsibilidad observada: aquí la confianza no crece a partir de un único gran logro, sino de muchas experiencias que estabilizan una expectativa, y de las condiciones que hacen posible esa observación.
Esto tiene una consecuencia inmediata para las empresas: quien no trabaja activamente con la IA no puede desarrollar una confianza adecuada ni definir límites adecuados. Una empresa que solo espera una herramienta o un modelo mejor se pierde la verdadera tarea de aprendizaje. Un modelo potente sin contexto suficiente, datos fiables y revisiones adecuadas es solo un camino más rápido hacia un resultado mal interpretado.
La IA necesita un «terreno de juego» definido, no solo una autorización
Este terreno de juego se puede observar desde dos perspectivas. Dentro del terreno está la pregunta de cómo puede trabajar la IA. Desde la banda, la pregunta es cómo gestiona la organización sus resultados.
La primera perspectiva podría llamarse marco de actuación y guardrails para la IA. Entre otros, incluye:
- la finalidad y el ámbito de aplicación permitido;
- las fuentes de datos y el contexto proporcionado;
- un modelo de información común;
- herramientas y acciones permitidas y prohibidas;
- requisitos sobre fuentes, forma y calidad de los resultados;
- umbrales y bloqueos técnicos;
- registro, versionado y bucles de retroalimentación.

Los guardrails son, en este sentido, más que indicaciones en el system prompt. Un límite que el propio agente puede superar o eludir no es un límite fiable. Por eso, las restricciones críticas deberían imponerse, en la medida de lo posible, fuera del modelo: por ejemplo, mediante permisos de acceso, umbrales de aprobación fijos, API gateways o lógica de proceso.
El segundo lado es la arquitectura de supervisión y responsabilidad de la organización. Aquí debe quedar claro:
- ¿Quién es responsable desde el punto de vista técnico?
- ¿Quién puede asumir o autorizar un resultado?
- ¿Cuándo debe la IA pausarse y escalar?
- ¿Qué resultados solo se observan y cuáles se revisan activamente?
- ¿Cómo se detecta, revierte y evalúa un error?
- ¿Quién puede elevar un nivel de autonomía, y quién puede volver a reducirlo?
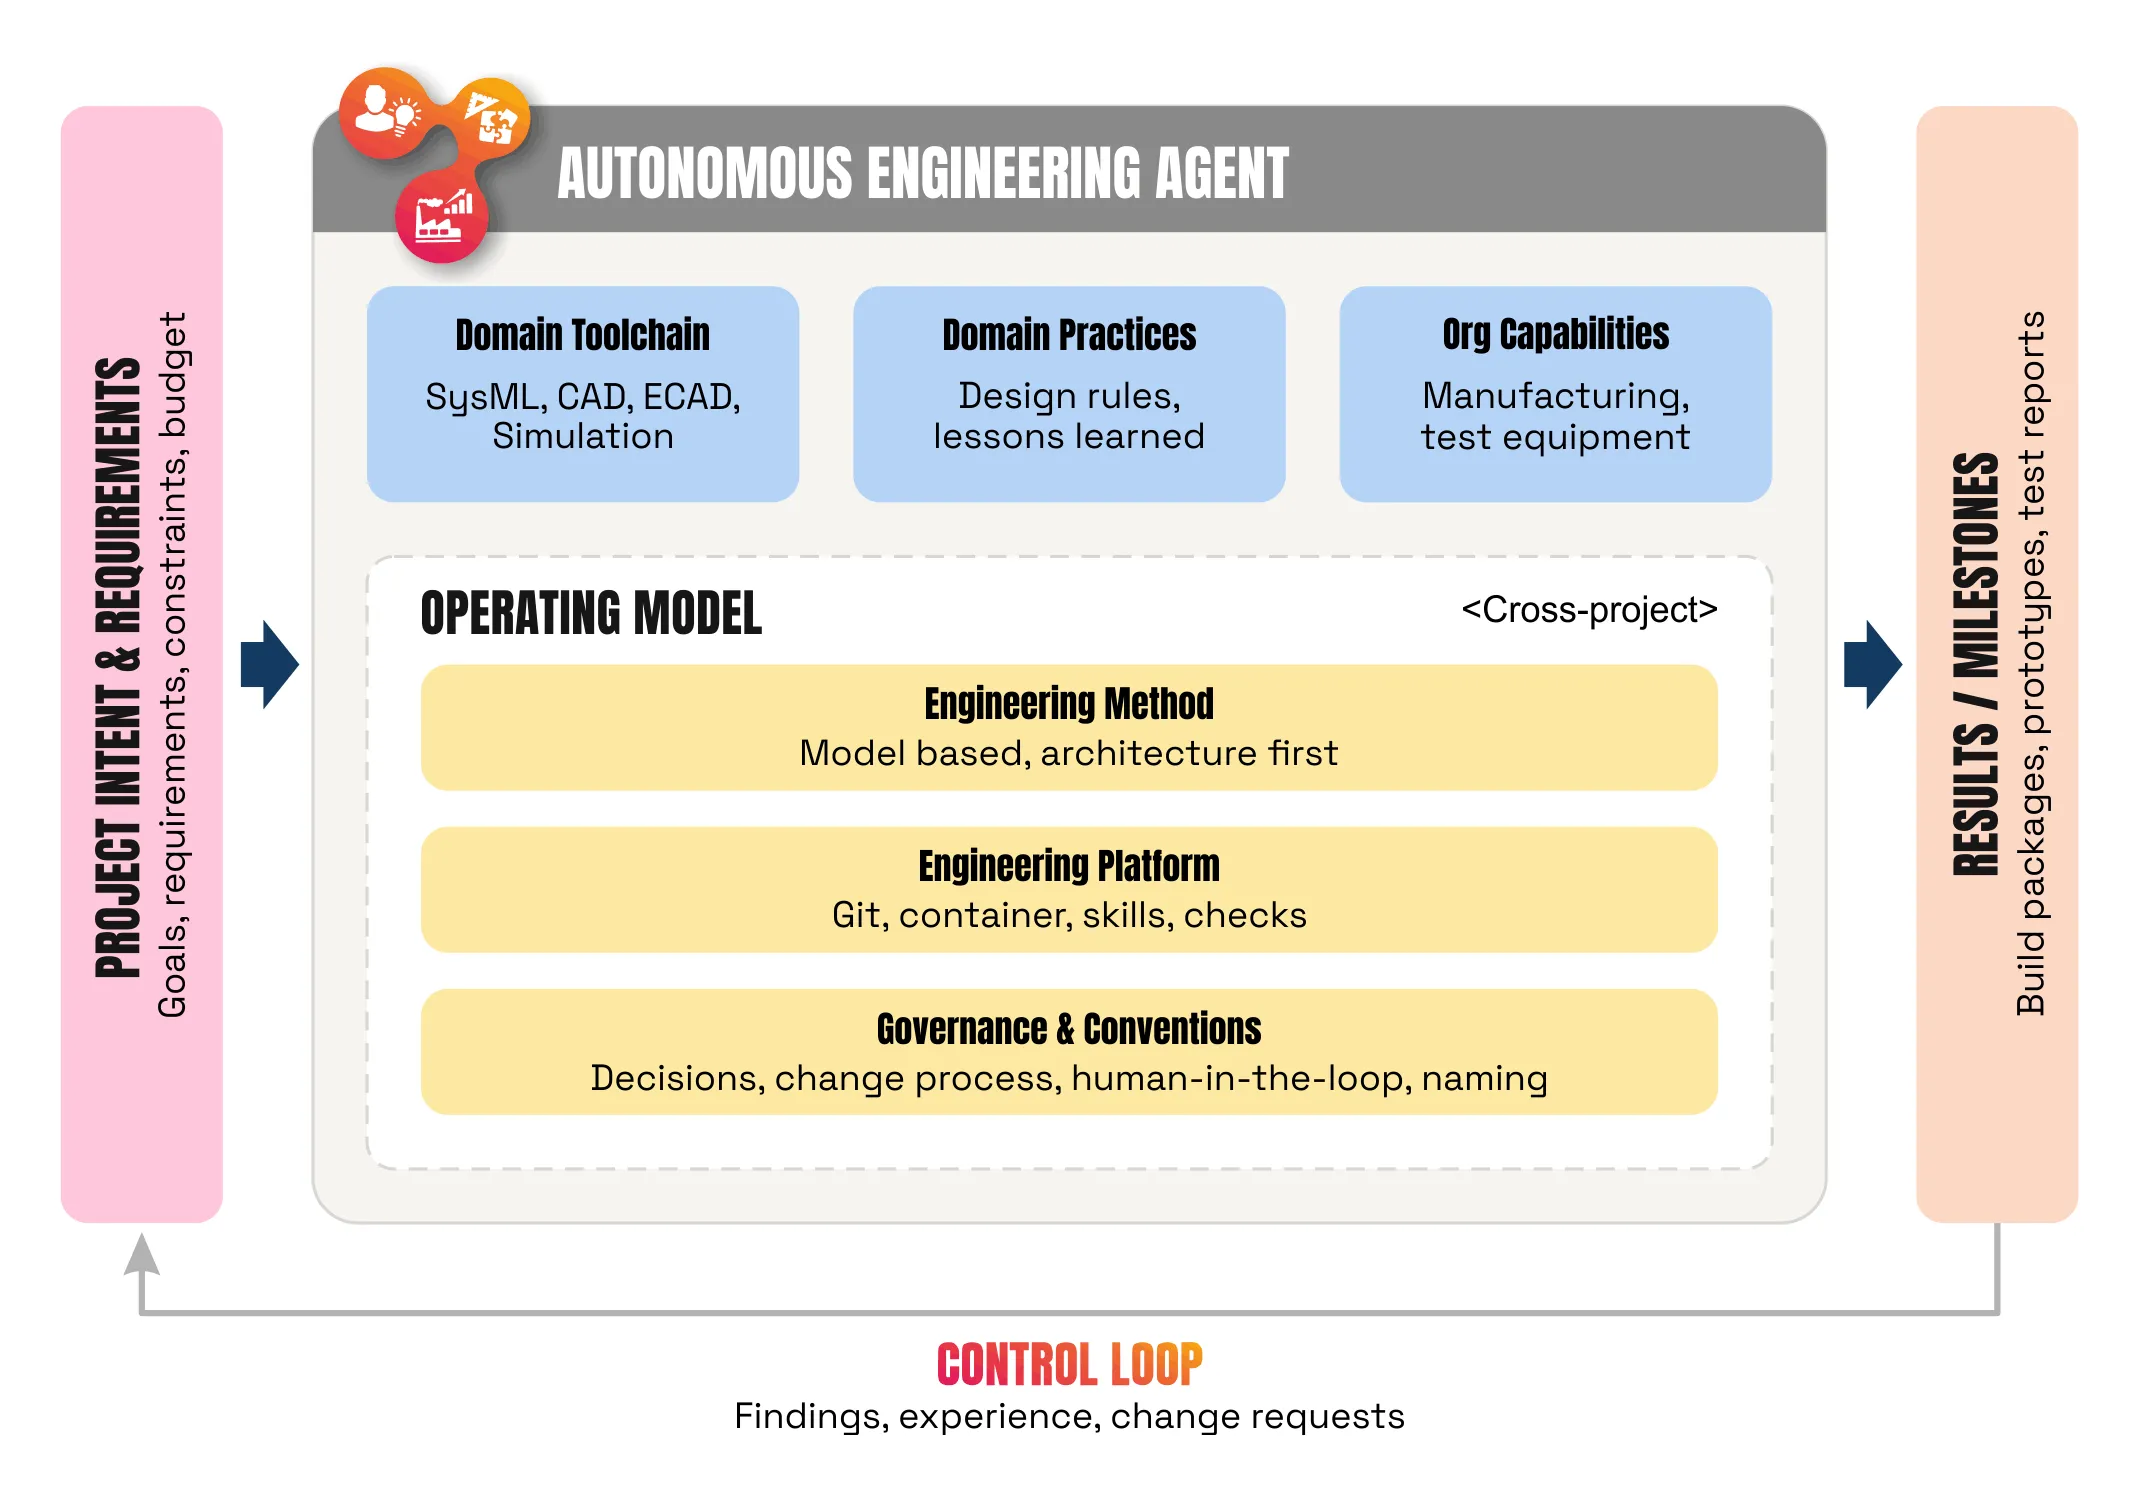
Governance y guardrails no son, por tanto, lo mismo. La governance define el marco organizativo: qué está permitido, quién es responsable y cómo se supervisa. Los guardrails traducen partes de ese marco en restricciones técnicas en tiempo de ejecución.

El arte consiste en no aplicar el mismo régimen de control a todas las tareas. Un simple servicio de resumen no debería pasar por el mismo proceso de autorización que un sistema que escribe en datos de producto críticos para la seguridad. Para ello, el MIT Center for Information Systems Research (van der Meulen, Jewer, Levallet) propone el concepto de minimum viable governance: tanta governance como sea necesaria para limitar eficazmente el riesgo. Por encima de cierto límite, según el grupo de investigación, la governance frena más de lo que protege: las decisiones se acumulan y la oportunidad real se pierde.
Esto no pretende ser un alegato a favor de menos governance, sino, desde luego, a favor de la governance adecuada.
La responsabilidad exige comprensión, pero no de cada detalle técnico
Pero una governance escalonada también significa que no toda acción de la IA termina en una mesa de revisión. Y con eso surge de inmediato una objeción: si los responsables no tienen que seguir cada paso de trabajo de la IA, ¿cómo pueden entonces asumir la responsabilidad?
La respuesta está en distinguir con más precisión el concepto de “comprender”. Para una supervisión responsable hay que diferenciar al menos cuatro niveles:
- Comprensión de contenido: ¿Qué significa el resultado para el producto, el proceso y la decisión?
- Comprensión del proceso: ¿Con qué datos, reglas, contextos, revisiones y autorizaciones se ha generado el resultado?
- Comprensión del riesgo: ¿Qué podría pasar si el resultado es incorrecto, incompleto o está fuera de su ámbito de validez?
- Comprensión técnica de detalle: ¿Cómo se puede reconstruir cada paso interno de procesamiento del modelo?
Los tres primeros niveles son habitualmente imprescindibles para tomar decisiones responsables. El cuarto puede ser relevante en casos especiales, pero no equivale a responsabilidad y, en procesos complejos, de todos modos solo se alcanza de forma limitada.
Tampoco el Reglamento de IA de la UE exige, para la supervisión humana de los sistemas de IA de alto riesgo, que cada cálculo interno del modelo pueda reconstruirse por completo. El art. 14 se centra en otra cosa: que las personas encargadas de la supervisión comprendan adecuadamente las capacidades y los límites del sistema, afronten conscientemente el sesgo de automatización y puedan interpretar, descartar o anular los resultados. El apdo. 3 exige además expresamente orientar la supervisión al riesgo, al grado de autonomía y al contexto de uso, es decir, precisamente la proporcionalidad de la que se trata aquí.
“No siempre es necesaria la comprensión técnica de detalle” no puede significar, por tanto, que se pueda prescindir de la comprensión técnica especializada. Una persona que solo puede pulsar un botón de aprobación, pero no puede valorar la afirmación, el proceso de generación y el posible daño, no ejerce una supervisión eficaz. Está presente en el proceso solo de forma formal.
El problema suele describirse como rubber-stamping: la persona permanece nominalmente en el bucle de control, pero de hecho se limita a dar el visto bueno. Por eso, el control sistémico solo es defendible cuando va unido a una comprensión real del proceso y del riesgo. El Reglamento de IA de la UE obliga a los operadores en este sentido — el art. 26 apdo. 2 exige encomendar la supervisión a personas que cuenten con la competencia, la formación y la autorización necesarias.
La ingeniería siempre ha controlado las entregas, no cada paso de pensamiento
Por eso, la comprensión del proceso y del riesgo no hay que aplicarla con la máxima profundidad en todos los puntos, sino en los puntos decisivos. La ingeniería lleva siempre haciendo esta selección de forma consciente: los buenos procesos de desarrollo no controlan cada actividad individual de un diseñador, un grupo de proyecto o un proveedor (aunque eso también ocurra, a menudo por razones económicas y de control de gestión). Colocan puntos de control allí donde cambia el riesgo, la responsabilidad o el estado de un resultado.
Las design reviews, la verificación y validación, el FMEA, las autorizaciones y los quality gates persiguen exactamente este propósito. No revisan cada razonamiento que ha llevado a un resultado (salvo en sectores especialmente regulados). Revisan si el resultado cumple los requisitos, si se han considerado los riesgos relevantes y si existen las evidencias necesarias.
También aquí sirve la analogía: la teoría de la organización y del control distingue entre control de comportamiento y control de resultados. La distinción se remonta a Ouchi; Eisenhardt la vincula con la teoría de la agencia. El control de comportamiento tiene sentido cuando quien controla entiende el proceso que convierte un input en un output. El control de resultados tiene sentido cuando los resultados se pueden describir y evaluar con claridad.
En un gran modelo de IA, controlar por completo el proceso interno de procesamiento no suele ser una base realista para la responsabilidad. Eso no significa que no se pueda controlar nada. Significa que el control debe desplazarse a otros puntos: el contexto, los datos, las reglas, las evidencias, la calidad del resultado y las entregas.
Por tanto, la governance de PLM para la IA no tiene que empezar de cero. Puede apoyarse en las lógicas existentes de ciclo de vida, autorización y cambio. Al mismo tiempo, la IA obliga a revisar estos procesos según su efecto real sobre el riesgo. Un proceso de cambio ya de por sí lento y burocrático no mejora automáticamente con aprobaciones individuales adicionales.
El grado de autonomía debe correlacionarse con el riesgo
Si el control debe aplicarse en las entregas relevantes, la organización tiene que decidir cuánto control necesita cada entrega. Para ello hace falta un criterio que vaya más allá de la simple pregunta «¿IA o no IA?».
Ya existen métodos para esto desde hace tiempo: el FMEA, por ejemplo, evalúa el riesgo de fallo mediante tres magnitudes: gravedad (¿qué tan grave es el efecto del fallo?), ocurrencia (¿qué probabilidad tiene?) y detección (¿qué probabilidad hay de que se detecte antes?). El sistema más antiguo multiplicaba estos valores para obtener el número de prioridad de riesgo (NPR); el FMEA armonizado AIAG-VDA de 2019 lo sustituye por una prioridad de acción. La seguridad funcional trabaja con un conjunto relacionado, pero planteado de otra forma: la ISO 26262 deriva el nivel de seguridad necesario (ASIL) a partir de la gravedad, la frecuencia de la situación de funcionamiento y la controlabilidad. La controlabilidad resulta especialmente reveladora para la cuestión de la delegación: ¿se puede todavía contener la situación si el fallo se produce? La tomo prestada como cuarta pregunta junto a las tres magnitudes del FMEA.
Estas magnitudes (las tres del FMEA, más la controlabilidad de la seguridad funcional) sirven como criterio de cuánta autonomía admite una tarea de IA.
Gravedad/Severidad
¿Hasta dónde se extiende un fallo en el producto, el proceso y la organización: se queda en el diseño, o avanza hasta compras, fabricación, homologación o comunicación con el cliente?
Probabilidad de ocurrencia
Se convierte en la pregunta sobre la calidad del contexto y la estabilidad del resultado: ¿tiene el sistema la información correcta, y produce con ella resultados reproducibles?
Probabilidad de detección
¿Existe un bucle de control (humano o automático) capaz de detectar errores, y si es así, con qué fiabilidad? Una grieta en un cordón de soldadura es una grieta en un cordón de soldadura. Un párrafo incorrecto de un texto de IA se lee igual que uno correcto.
Controlabilidad
Se convierte, en gran medida, en la pregunta sobre la reversibilidad: ¿se puede deshacer por completo una acción inducida por la IA, y en todos los sistemas a los que ya se haya propagado?
Para la combinación de propagación y reversibilidad circula, además, en el debate práctico sobre agentes de IA, el concepto de radio de impacto (en inglés blast radius, tomado de la operación de TI y de la nube, donde ya es en sí una metáfora del análisis de efectos de una explosión): el alcance del daño que una decisión errónea puede causar antes de que alguien la contenga. La regla práctica al respecto – la supervisión debe crecer con el radio de impacto – procede del blog de un proveedor de herramientas para agentes de programación. El concepto no sustituye la lógica del FMEA, pero puede complementarla.
Por eso, la autonomía no debería fijarse de forma genérica para un modelo o un agente. Es una decisión de diseño consciente, no una consecuencia automática de la mejora de las capacidades del modelo. Esto se repite en varios marcos de autonomía, desde los niveles de autonomía del Knight First Amendment Institute hasta el modelo de niveles de autonomía de la Cloud Security Alliance. Para una tarea, la IA puede hacer propuestas; para otra, preparar análisis; y para una tercera, actuar de forma autónoma dentro de límites estrictos.
Una gradación pragmática podría tener este aspecto:
| Nivel | Denominación | Qué puede hacer la IA |
|---|---|---|
| 01 | Proponer | La IA genera borradores, resúmenes, clasificaciones o resultados de búsqueda. El uso posterior queda fuera de la IA y lo deciden las personas. |
| 02 | Preparar e informar | La IA relaciona información, analiza impactos o completa datos de cambio. Influye en una decisión, pero no la desencadena por sí sola. |
| 03 | Ejecutar dentro de límites estrictos | La IA puede desencadenar una acción por sí misma cuando el alcance, el acceso a datos, los umbrales, el registro, la reversión y la escalada están claramente regulados. |
Estos niveles no son una norma rígida. Según la empresa y el caso de uso, pueden tener sentido niveles más matizados.
Hacer de la IA un asunto de dirección, pero no de burocracia
Estos criterios no se pueden imponer mediante una directriz. Quien los convierte en un formulario obtiene un formulario, no un mejor juicio sobre cuánta autonomía admite cada tarea. Ese juicio se forma en la organización, y para ello hacen falta algunas pautas a nivel directivo.
Primero: la IA debe convertirse en una tarea de aprendizaje compartida. No es solo un tema de TI, de datos o de compliance. Ingeniería, las áreas especializadas, calidad, TI y la dirección deben desarrollar una comprensión común de lo que el sistema puede hacer, dónde falla y qué consecuencias tendría un error. Para ello hace falta trabajo práctico con tareas reales. Las aplicaciones de bajo riesgo no son solo herramientas de productividad, sino campos de aprendizaje. Ayudan a calibrar expectativas, a reconocer patrones de error y a fundamentar la confianza en experiencias sólidas.
Segundo: probar debe estar permitido. Una empresa que trata cada prueba como si fuera una implementación crítica para la producción aprenderá solo despacio, o (quizá) peor aún, al margen de la governance oficial. Una governance excesiva e inadecuada puede fomentar la shadow AI: los empleados buscan la vía más rápida y no oficial, y así sustraen precisamente el uso al control previsto. Probar, sin embargo, no significa ignorar los riesgos. Significa acotar los experimentos de forma que la organización pueda aprender sin generar consecuencias incontrolables.
Tercero: la autonomía debe vincularse a evidencias. No debería decidir sobre un nivel de autonomía más alto la valoración general de «ya confiamos en el sistema». Lo relevante son evidencias concretas: ¿para qué tarea son fiables los resultados? ¿Bajo qué condiciones? ¿Qué errores se detectan? ¿Con qué rapidez se puede intervenir o revertir? ¿Quién decide sobre la subida y la bajada de nivel?
Cuarto: los procesos de ingeniería existentes no deberían ampliarse sin más, sino revisarse o incluso replantearse por completo. La introducción de la IA es una ocasión para preguntarse si los gates existentes realmente actúan sobre los riesgos relevantes. Añadir una autorización adicional para cada acción de la IA a un proceso de cambio ya de por sí sobrecargado solo aumenta la burocracia, no la seguridad.
La confianza es el resultado de buenas condiciones
La IA solo podrá desplegar todo su valor en ingeniería cuando las empresas le den no solo tareas, sino también un margen de actuación adecuado. Ese margen de actuación no debe surgir de la euforia ni bloquearse por miedo.
Y la confianza en la IA no es un interruptor de encendido y apagado. Es específica por tarea, se basa en la observación y es revocable. Crece cuando una empresa trabaja activamente con la IA, conoce sus capacidades y sus límites, y extrae consecuencias de sus resultados.
Para ello hace falta un buen contexto, pautas claras, puntos de control relevantes, resultados visibles, responsabilidad definida y una posibilidad real de reducir el nivel de autonomía.
Quien solo controla sin aprender queda atrapado en un control al detalle. Quien solo confía sin observar confunde la esperanza con la governance.
El futuro de la ingeniería no está, por tanto, ni en el control total de la IA ni en su autonomía total. Está en la capacidad de darle margen de actuación precisamente allí donde las personas han entendido su rendimiento, sus límites y las consecuencias de un error.
Preguntas y respuestas
¿Por qué la IA en ingeniería no solo necesita reglas, sino también confianza?
Porque una IA solo despliega todo su valor cuando se le confían una tarea y un margen de actuación. Quien hace autorizar cada acción individual acaba con un sistema bien protegido, pero apenas gana algo. La confianza no es aquí un anticipo, sino la disposición fundamentada a confiar en el sistema para una tarea concreta bajo incertidumbre.
¿Cuál es la diferencia entre la governance de IA y los guardrails?
La governance es el marco organizativo: qué está permitido, quién es responsable desde el punto de vista técnico, quién autoriza, cómo se supervisa. Los guardrails traducen parte de ese marco en restricciones técnicas en tiempo de ejecución: permisos de acceso, umbrales, API gateways, lógica de proceso. Lo decisivo: un límite que el propio agente puede superar no es un límite. Las restricciones críticas deben imponerse fuera del modelo.
¿Cuánta autonomía debería tener una IA en PLM e ingeniería?
Tanta como admita la tarea individual: la autonomía se asigna por tarea, no de forma genérica por modelo. Tres niveles sirven de orientación: proponer (la IA genera borradores, las personas deciden su uso), preparar e informar (la IA relaciona información y analiza impactos, pero no desencadena la decisión) y ejecutar dentro de límites estrictos (la IA actúa por sí misma cuando el alcance, el acceso a datos, el registro, la reversión y la escalada están regulados).
¿Cómo se evalúa el riesgo de una tarea de IA?
Mediante cuatro preguntas tomadas de métodos de ingeniería consolidados. Del FMEA: propagación (¿hasta dónde se extiende un fallo en el producto, el proceso y la organización?), calidad del contexto (¿tiene el sistema la información correcta?) y observabilidad (¿se detecta el fallo antes de que surta efecto?). A esto se añade la controlabilidad de la seguridad funcional según la ISO 26262, aquí como reversibilidad: ¿se puede deshacer la acción en todos los sistemas afectados? Propagación y reversibilidad juntas dan el radio de impacto (blast radius), y la supervisión debe crecer con él.
¿Basta el human-in-the-loop como supervisión de los sistemas de IA?
No. Una persona en el proceso todavía no es una supervisión eficaz. Para serlo, esa persona debe recibir la información relevante, poder valorar el resultado en cuanto a su contenido, estimar sus consecuencias y poder intervenir realmente. Si faltan tiempo, competencia o posibilidad de revertir, se produce rubber-stamping: la persona permanece nominalmente en el bucle de control, pero se limita a dar el visto bueno. El control individual completo no ayuda frente a esto: genera fatiga de aprobación y, con ella, precisamente el sesgo de automatización que se quería evitar.
¿Qué exige el Reglamento de IA de la UE sobre la supervisión humana de la IA?
El art. 14 no exige, para los sistemas de IA de alto riesgo, que cada cálculo interno del modelo sea reconstruible. Se exige que las personas encargadas de la supervisión comprendan adecuadamente las capacidades y los límites del sistema, afronten conscientemente el sesgo de automatización y puedan interpretar, descartar o anular los resultados. El apdo. 3 exige orientar la supervisión al riesgo, al grado de autonomía y al contexto de uso; el art. 26 apdo. 2 obliga a los operadores a encomendarla a personas con la competencia, la formación y la autorización necesarias.
¿Puede demasiada governance obstaculizar el uso de la IA?
Sí. El MIT Center for Information Systems Research lo resume como minimum viable governance: tanta governance como sea necesaria para limitar eficazmente el riesgo. Por encima de ese límite, frena más de lo que protege: las decisiones se acumulan y la oportunidad se pierde. Además, una governance inadecuada fomenta la shadow AI: los empleados recurren a la vía no oficial y sustraen el uso precisamente al control previsto.