Que l’IA ait besoin de règles en PLM et en ingénierie, tout le monde l’a déjà entendu. Il s’agit d’accès aux données, de responsabilités, d’approbations, de preuves et de la question de savoir quelles tâches un système peut même assumer. Et à la fin, c’est toujours un humain qui doit porter la responsabilité.
Je voudrais ajouter un point important à cela : l’IA en ingénierie n’a pas seulement besoin de règles, mais aussi de confiance.
Je ne le dis pas avec ironie. Et ce n’est pas non plus un plaidoyer pour accorder d’emblée un crédit de confiance à une IA. La confiance est ici entendue de façon tout à fait constructive : comme condition pour que l’IA puisse déployer son utilité. Qui ne peut confier à une IA ni tâche ni marge de manœuvre obtient peut-être un système bien sécurisé – mais n’y gagne probablement rien.
En même temps, la confiance ne naît pas d’une décision. Elle ne se décrète pas dans une directive et ne se remplace pas non plus en exigeant qu’un humain valide chaque action individuellement. La confiance doit se construire : par un engagement actif avec l’IA, par des essais limités, par l’observation de ses résultats et par une compréhension croissante de ses capacités et de ses limites.
La vraie question de management n’est donc pas seulement : de quelles règles l’IA a-t-elle besoin ? Elle est aussi : pour quoi, dans quelles conditions et avec quelles conséquences sommes-nous prêts à nous appuyer sur elle ?
C’est particulièrement concret en ingénierie : quand une IA résume une réunion sur les exigences, signale une contradiction ou recherche des pièces similaires, une erreur est le plus souvent(!) gênante, mais maîtrisable. Quand la même IA modifie une nomenclature approuvée, formule une affirmation de conformité ou déclenche un processus de modification jusqu’à la fabrication, la situation est différente.
La confiance n’est pas un blanc-seing
« La confiance, c’est bien, le contrôle, c’est mieux » : c’est vite dit, et ça sonne juste. La phrase contient d’ailleurs un noyau important : les résultats ne devraient pas être repris sans vérification. Mais face à l’IA, elle induit en erreur dès lors que le contrôle est assimilé à la vérification de chaque étape de travail individuelle.
Car le contrôle intégral de chaque action ne scale pas. Qui valide chaque action de l’IA une par une ne crée pas automatiquement plus de sécurité. Avec un nombre croissant de décisions, la pression du temps, l’habitude et la lassitude de validation menacent. La recherche sur l’automation bias décrit exactement cet effet : qui travaille avec un système automatisé vérifie ses sorties avec de moins en moins de rigueur au fil du temps et manque des erreurs qui auraient été remarquées sans l’automatisation. On finit alors peut-être par valider sans le voir ce qu’on voulait justement vérifier soigneusement.
Le contrôle n’est donc pas gratuit. Il coûte du temps, de l’attention et de la capacité de décision. Et il peut lui-même devenir un risque lorsqu’il s’applique aux mauvais endroits.
Mais la confiance aveugle n’est pas une alternative. Un résultat formulé de façon plausible (l’AI slop) n’est pas encore un résultat solide. Une IA peut paraître convaincante alors même que le contexte lui manque, que les données sont mal reliées ou qu’elle traite une tâche hors de son domaine d’application approprié.
La question décisive n’est donc pas : faisons-nous confiance à l’IA ? Mais plutôt : pour quoi, dans quelles conditions et avec quelles conséquences sommes-nous prêts à nous appuyer sur elle ?
La confiance, c’est déléguer dans l’incertitude
Dans la recherche sur la confiance, la confiance n’est pas comprise comme la certitude que l’autre partie se comportera correctement. La confiance désigne plutôt la volonté de s’engager envers une autre partie malgré l’incertitude et une certaine vulnérabilité. Mayer, Davis et Schoorman ont décrit cette perspective de façon marquante pour les organisations.
Pour l’usage de l’automatisation, une distinction similaire est importante : l’objectif n’est pas le plus de confiance possible, mais une attente de fiabilité appropriée. Lee et See parlent à ce sujet d’appropriate reliance : les personnes doivent s’appuyer sur l’automatisation lorsqu’elle est adaptée à une tâche – tout en restant capables d’observer, de questionner ou de rejeter ses résultats.
Cela paraît abstrait, mais devient vite concret en ingénierie. La confiance envers une IA n’est pas globale. Elle ne dit pas : « nous faisons confiance à ce modèle. » Elle dit plutôt :
Nous faisons confiance à ce système pour cette tâche, avec ces données, dans ce processus et dans ces limites.
Au moins trois questions sont décisives pour cela :
Capacité. L’IA peut-elle accomplir cette tâche concrète de façon suffisamment bonne ?
Fiabilité. Travaille-t-elle de façon constante dans des conditions comparables et dans le cadre prévu ?
Adéquation à l’objectif. Ce système convient-il à l’objectif pour lequel nous l’utilisons ?
C’est justement le dernier point qui est sous-estimé. Une IA générique peut être utile pour de nombreuses tâches. Mais cela ne signifie pas qu’elle convient à chaque tâche. Un système qui résume bien des textes n’est pas automatiquement un système qui devrait modifier des données produit approuvées.
Une IA n’a pas de caractère au sens humain ni de conscience propre de ses responsabilités. Mais elle n’est pas non plus une instance parfaitement neutre. Les données d’entraînement, le comportement du modèle, les consignes système et le contexte fourni déterminent la façon dont elle répond, ce qu’elle priorise, ce qu’elle omet et la manière dont elle gère l’incertitude. Cette « attitude » n’est pas une personnalité. Elle reste néanmoins pertinente pour savoir si le système correspond à l’objectif et aux règles de l’entreprise.
La confiance naît d’un engagement actif
J’aime bien utiliser l’analogie suivante : avec un nouveau collaborateur ou une nouvelle équipe, on ne sait pas encore exactement, au début, ce qu’on peut en attendre. On connaît certes le CV ou la description de l’équipe. Mais on ne connaît pas les compétences par expérience propre. On ne sait pas comment quelqu’un gère des exigences floues, la pression du temps ou les erreurs. C’est pourquoi la collaboration commence généralement par des tâches limitées, des questions, de l’observation et du retour.
Avec le temps se forme une image : que sait faire cette personne ? Où travaille-t-elle de façon fiable ? Quand a-t-elle besoin de soutien ? Quelle responsabilité peut-elle assumer ? Quand cette image se stabilise, le contrôle au détail peut diminuer.
L’analogie du nouveau collaborateur aide aussi pour l’usage de l’IA. Elle a toutefois une limite importante : un collaborateur adapté peut comprendre des règles, poser des questions, apprendre de l’expérience et adapter son comportement à de nouvelles situations. Une IA ne le fait pas automatiquement de la même manière. Son cadre de travail (et la boucle d’apprentissage) doit être davantage mis en place techniquement et organisationnellement.
C’est pourquoi la confiance envers l’IA ne naît pas d’une décision, ni d’une présentation sur les capacités du dernier modèle. Elle naît d’un engagement actif avec le système concret :
- donner des tâches réelles, mais limitées ;
- observer les résultats et les schémas d’erreur ;
- identifier les contextes adaptés et inadaptés ;
- comparer les attentes avec la performance réelle ;
- adapter les règles, les prompts, l’accès aux données et les vérifications ;
- étendre ou réduire l’autonomie.
Le cycle suivant est déterminant pour la boucle d’apprentissage :
essayer → observer → situer → restreindre ou étendre → observer à nouveau
La recherche sur la confiance décrit une évolution similaire. Lewicki et Bunker distinguent une confiance calculée, qui s’appuie sur des garanties et des sanctions, d’une confiance qui naît d’échanges répétés et d’une prévisibilité observée – et enfin d’une confiance fondée sur des valeurs partagées et une identification. La troisième étape n’est pas disponible pour l’IA. C’est précisément pour cette raison que la relation avec l’IA reste durablement dépendante de la prévisibilité observée : la confiance n’y croît pas d’une seule grande performance, mais de nombreuses expériences qui stabilisent une attente – et de conditions qui rendent cette observation possible en premier lieu.
Cela a une conséquence immédiate pour les entreprises : qui ne s’engage pas activement avec l’IA ne peut développer ni une confiance appropriée ni des limites appropriées. Une entreprise qui attend seulement un meilleur outil ou modèle rate la véritable tâche d’apprentissage. Un modèle performant sans contexte suffisant, données fiables et vérifications adaptées n’est qu’un chemin plus rapide vers un résultat mal compris.
L’IA a besoin d’un « terrain de jeu » défini – pas seulement d’une autorisation
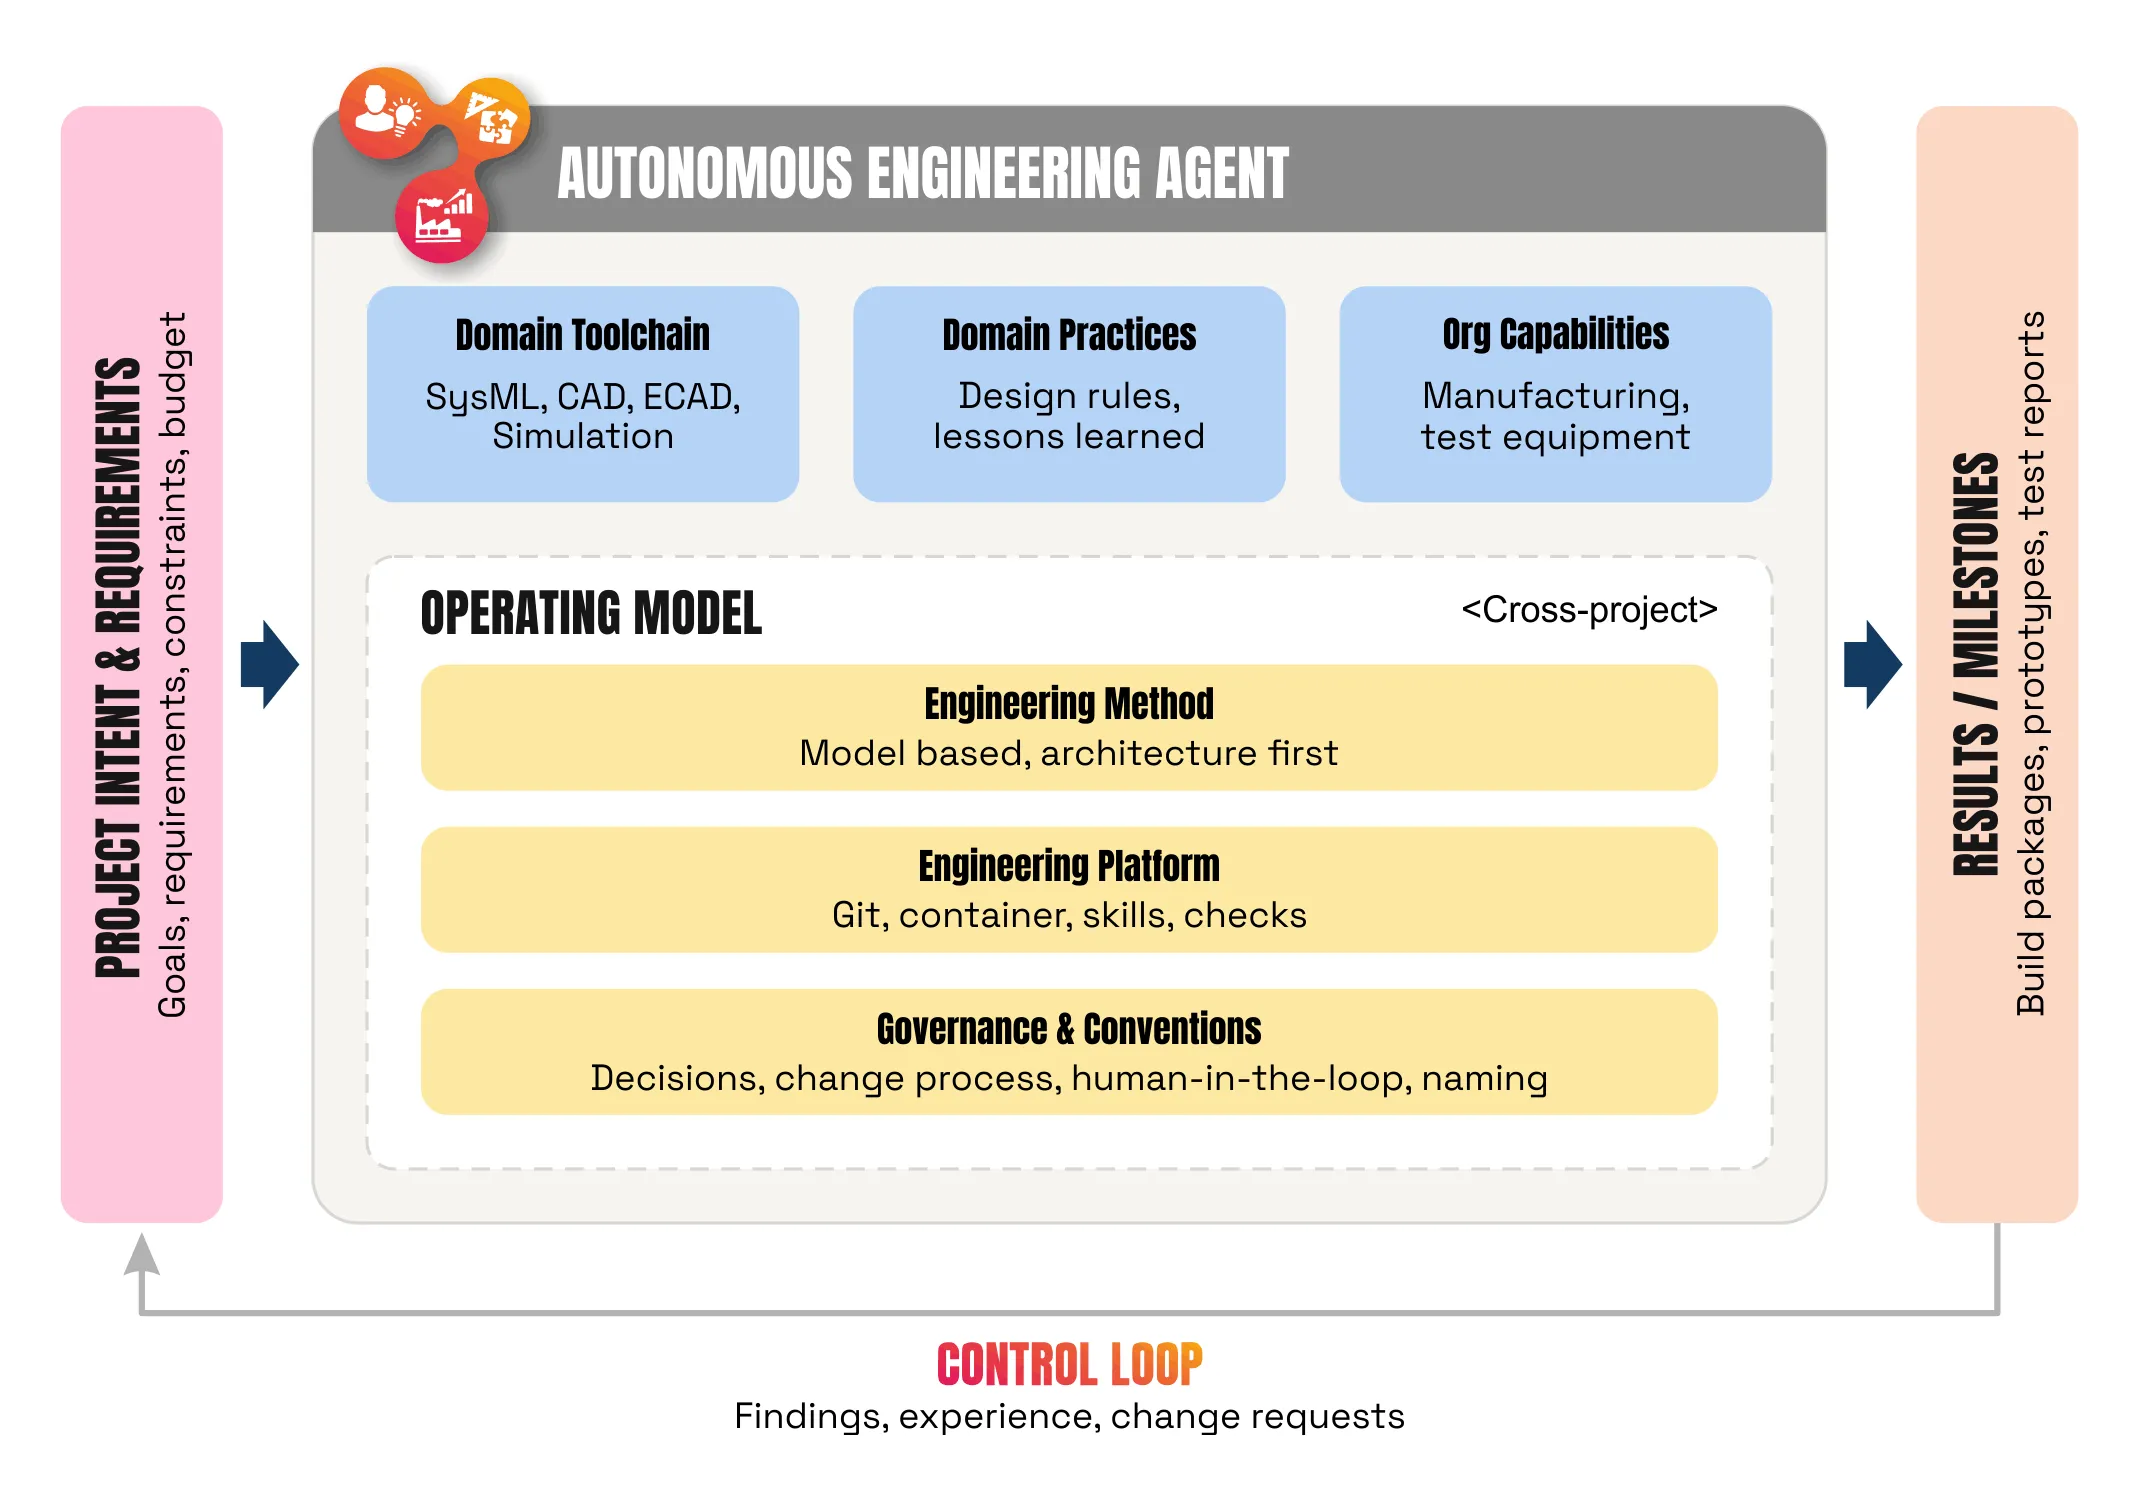
Ce terrain de jeu peut être considéré sous deux angles. Sur le terrain lui-même se pose la question de la manière dont l’IA est autorisée à travailler. Depuis le bord du terrain se pose la question de la manière dont l’organisation gère ses résultats.
On pourrait appeler la première perspective cadre d’action et garde-fous pour l’IA. En font partie notamment :
- l’objectif et le domaine d’application autorisé ;
- les sources de données et le contexte fourni ;
- un modèle d’information commun ;
- les outils et actions autorisés et interdits ;
- les exigences sur les sources, la forme et la qualité des résultats ;
- les seuils et les verrous techniques ;
- la journalisation, le versionnage et les boucles de retour.

Les garde-fous sont ici plus que des indications dans le prompt système. Une limite que l’agent peut lui-même dépasser ou contourner n’est pas une limite solide. Les restrictions critiques devraient donc être appliquées autant que possible en dehors du modèle – par exemple via des droits d’accès, des seuils d’approbation fixes, des passerelles API ou la logique du processus.
L’autre face est l’architecture de supervision et de responsabilité de l’organisation. Il faut ici être clair sur :
- qui est responsable sur le fond ?
- qui peut reprendre ou approuver un résultat ?
- quand l’IA doit-elle s’arrêter et escalader ?
- quels résultats sont seulement observés, lesquels activement vérifiés ?
- comment une erreur est-elle détectée, annulée et analysée ?
- qui peut relever un niveau d’autonomie – et qui peut le réduire à nouveau ?
Gouvernance et garde-fous ne sont donc pas la même chose. La gouvernance définit le cadre organisationnel : qu’est-ce qui est permis, qui est responsable et comment la supervision s’exerce-t-elle ? Les garde-fous traduisent une partie de ce cadre en restrictions techniques au moment de l’exécution.

L’art consiste à ne pas appliquer le même régime de contrôle à chaque tâche. Un simple service de résumé ne devrait pas suivre le même processus d’approbation qu’un système qui écrit dans des données produit critiques pour la sécurité. Le MIT Center for Information Systems Research (van der Meulen, Jewer, Levallet) propose pour cela le terme de minimum viable governance : autant de gouvernance que nécessaire pour limiter efficacement le risque. Au-delà d’un certain plafond, selon ce groupe de recherche, la gouvernance freine plus qu’elle ne protège – les décisions s’accumulent, et l’opportunité réelle passe.
Ce n’est pas un plaidoyer pour moins de gouvernance, mais bel et bien pour une gouvernance adaptée.
La responsabilité exige de la compréhension – mais pas de chaque détail technique
Une gouvernance graduée signifie aussi : chaque action de l’IA ne finit pas sur une table d’examen. Et une objection se pose immédiatement. Si les responsables ne doivent pas retracer chaque étape de travail de l’IA, comment peuvent-ils alors assumer leur responsabilité ?
La réponse se trouve dans une distinction plus fine du terme « comprendre ». Pour une supervision responsable, il faut distinguer au moins quatre niveaux :
- Compréhension du contenu : que signifie le résultat pour le produit, le processus et la décision ?
- Compréhension du processus : dans quelles conditions de données, de règles, de contextes, de vérifications et d’approbations le résultat est-il né ?
- Compréhension du risque : que pourrait-il se passer si le résultat est faux, incomplet ou hors de son champ d’application ?
- Compréhension technique détaillée : comment reconstituer chaque étape de traitement interne du modèle ?
Les trois premiers niveaux sont régulièrement indispensables pour des décisions responsables. Le quatrième peut être pertinent dans des cas particuliers, mais ne peut être assimilé à la responsabilité et n’est de toute façon que partiellement accessible dans des processus complexes.
Même l’AI Act de l’UE n’exige pas, pour la supervision humaine des systèmes d’IA à haut risque, que chaque calcul interne du modèle puisse être entièrement reconstitué. L’art. 14 vise autre chose : que les personnes chargées de la supervision comprennent de façon appropriée les capacités et les limites du système, répondent consciemment à l’automation bias et puissent situer, rejeter ou outrepasser les résultats. Le par. 3 exige en outre expressément d’aligner la supervision sur le risque, le degré d’autonomie et le contexte d’usage – donc précisément la proportionnalité dont il est question ici.
« La compréhension technique détaillée n’est pas toujours nécessaire » ne peut donc pas signifier que la compréhension métier est superflue. Un humain qui ne peut que cliquer sur un bouton d’approbation, sans pouvoir juger l’affirmation, le processus d’origine et le dommage possible, n’exerce pas une supervision efficace. Il n’est que formellement présent dans le processus.
Ce problème est souvent décrit comme du rubber-stamping : l’humain reste nominalement dans la boucle, mais devient de fait un simple tampon. Un contrôle systémique n’est donc responsable que s’il est associé à une véritable compréhension du processus et du risque. L’AI Act de l’UE engage les exploitants dans ce sens – l’art. 26, par. 2 exige de confier la supervision à des personnes disposant pour cela de la compétence, de la formation et de l’autorité nécessaires.
L’ingénierie contrôle depuis toujours les passations, pas chaque étape de réflexion
La compréhension du processus et du risque n’a donc pas besoin d’être maximale partout, mais aux endroits décisifs. L’ingénierie fait ce choix de façon délibérée depuis toujours : les bons processus de développement ne contrôlent pas chaque activité individuelle d’un concepteur, d’une équipe de projet ou d’un fournisseur (même si cela arrive, souvent pour des raisons économiques et de contrôle de gestion). Ils placent des points de contrôle là où le risque, la responsabilité ou le statut d’un résultat changent.
Les revues de conception, la vérification et la validation, l’AMDEC, les approbations et les quality gates poursuivent exactement cet objectif. Ils ne vérifient pas chaque réflexion qui a conduit à un résultat (exception : les secteurs particulièrement strictement réglementés). Ils vérifient si le résultat répond aux exigences, si les risques pertinents ont été examinés et si les preuves nécessaires sont disponibles.
À nouveau l’analogie ici : la théorie des organisations et du contrôle distingue le contrôle du comportement et le contrôle du résultat. La distinction remonte à Ouchi ; Eisenhardt la relie à la théorie de l’agence. Le contrôle du comportement a du sens quand le contrôleur comprend le processus qui transforme une entrée en sortie. Le contrôle du résultat a du sens quand les résultats peuvent être clairement décrits et évalués.
Pour un grand modèle d’IA, un contrôle complet du traitement interne n’est en général pas une base réaliste pour la responsabilité. Cela ne signifie pas qu’on ne peut rien contrôler. Cela signifie que le contrôle doit être déplacé vers d’autres points : le contexte, les données, les règles, les preuves, la qualité des résultats et les passations.
La gouvernance PLM pour l’IA ne doit donc pas repartir de zéro. Elle peut s’appuyer sur les logiques existantes de cycle de vie, d’approbation et de modification. En même temps, l’IA oblige à examiner ces processus sous l’angle de leur impact réel sur le risque. Un processus de modification déjà lent et bureaucratique ne devient pas automatiquement meilleur avec des approbations individuelles supplémentaires.
Le degré d’autonomie doit être corrélé au risque
Si le contrôle doit s’appliquer aux passations pertinentes, l’organisation doit décider quelles passations nécessitent combien de contrôle. Il faut pour cela un critère qui dépasse la simple question « IA ou pas d’IA ? ».
Des méthodes existent depuis longtemps pour cela : l’AMDEC, par exemple, évalue un risque d’erreur à partir de trois grandeurs : la gravité (quelle est la portée de l’erreur ?), l’occurrence (quelle est sa probabilité ?) et la détection (quelle est la probabilité qu’elle soit repérée avant ?). L’ancienne systématique multipliait ces valeurs pour obtenir le nombre de priorité de risque (RPN) ; l’AMDEC harmonisée AIAG-VDA de 2019 la remplace par une priorité d’action. La sécurité fonctionnelle travaille avec un jeu apparenté, mais découpé différemment : l’ISO 26262 déduit le niveau de sécurité nécessaire (ASIL) de la gravité, de la fréquence de la situation d’exploitation et de la maîtrisabilité. La maîtrisabilité est particulièrement instructive pour la question de la délégation – la situation peut-elle encore être rattrapée si l’erreur se produit ? Je l’emprunte comme quatrième question aux trois grandeurs de l’AMDEC.
Ces grandeurs (les trois de l’AMDEC, complétées par la maîtrisabilité issue de la sécurité fonctionnelle) sont adaptées comme critère pour déterminer combien d’autonomie une tâche d’IA peut supporter.
Gravité
Jusqu’où une erreur se répercute-t-elle dans le produit, le processus et l’organisation – reste-t-elle au stade de la conception, ou se poursuit-elle dans l’approvisionnement, la fabrication, l’homologation ou la communication client ?
Probabilité d'occurrence
Devient la question de la qualité du contexte et de la stabilité des résultats : le système dispose-t-il des bonnes informations – et livre-t-il ainsi des résultats reproductibles ?
Probabilité de détection
Existe-t-il une boucle de contrôle (humaine ou machine) capable de détecter une erreur, et si oui, avec quelle fiabilité ? Une fissure dans un cordon de soudure est une fissure dans un cordon de soudure. Un paragraphe erroné d’un texte d’IA se lit comme un paragraphe correct.
Maîtrisabilité
Devient largement la question de la réversibilité : une action induite par l’IA peut-elle être entièrement annulée, et cela dans tous les systèmes dans lesquels elle s’est déjà propagée ?
Pour la combinaison entre propagation et réversibilité circule, dans le débat pratique sur les agents d’IA, le terme complémentaire de rayon d’impact (en anglais blast radius, emprunté à l’exploitation IT et cloud, où il est déjà lui-même une métaphore issue de l’analyse des effets d’une explosion) : l’étendue du dommage qu’une décision erronée peut causer avant que quelqu’un ne la rattrape. La règle pratique qui en découle – la supervision doit croître avec le rayon d’impact – provient du blog d’un fournisseur d’outils pour agents de codage. Le terme ne remplace pas la logique de l’AMDEC, mais peut la compléter.
L’autonomie ne devrait donc pas être fixée de façon générale pour un modèle ou un agent. C’est une décision de conception délibérée, pas une conséquence automatique de l’amélioration des capacités des modèles. Cela se retrouve dans plusieurs cadres d’autonomie, des niveaux d’autonomie du Knight First Amendment Institute au modèle de niveaux d’autonomie de la Cloud Security Alliance. Pour une tâche, l’IA peut faire des propositions, pour une autre préparer des analyses et pour une troisième agir de façon autonome dans des limites strictes.
Une gradation pragmatique pourrait se présenter ainsi :
| Niveau | Désignation | Ce que l’IA est autorisée à faire |
|---|---|---|
| 01 | Proposer | L’IA produit des ébauches, des résumés, des classifications ou des résultats de recherche. L’usage ultérieur reste hors de l’IA et est décidé par des humains. |
| 02 | Préparer et informer | L’IA relie des informations, analyse des impacts ou alimente des données de modification. Elle influence une décision, mais ne la déclenche pas seule. |
| 03 | Exécuter dans des limites strictes | L’IA peut déclencher elle-même une action si l’étendue, l’accès aux données, les seuils, la journalisation, la réversibilité et l’escalade sont clairement réglés. |
Ces niveaux ne sont pas une norme rigide. Selon l’entreprise et le cas d’usage, des niveaux plus nuancés peuvent être pertinents.
Faire de l’IA une affaire de direction – mais pas de bureaucratie
De tels critères ne se décrètent pas par directive. Qui les coule dans un formulaire obtient un formulaire, pas un meilleur jugement sur la quantité d’autonomie qu’une tâche peut supporter. Ce jugement naît dans l’organisation, et il faut pour cela quelques garde-fous au niveau de la direction.
Premièrement : l’IA doit devenir une tâche d’apprentissage commune. Elle n’est pas seulement un sujet informatique, de données ou de conformité. L’ingénierie, les métiers, la qualité, l’IT et la direction doivent développer une compréhension commune de ce que le système sait faire, où il échoue et quelles seraient les conséquences d’une erreur. Cela nécessite un engagement pratique avec de vraies tâches. Les applications à faible risque ne sont pas seulement des outils de productivité, mais des terrains d’apprentissage. Elles aident à calibrer les attentes, à reconnaître les schémas d’erreur et à fonder la confiance sur des expériences solides.
Deuxièmement : l’essai doit être autorisé. Une entreprise qui traite chaque expérimentation comme une mise en production critique n’apprendra que lentement – ou, pire, le fera en contournant la gouvernance officielle. Une gouvernance excessive et inadaptée peut favoriser le shadow AI : les collaborateurs cherchent la voie plus rapide et non officielle, et soustraient ainsi l’usage au contrôle justement prévu. Essayer ne signifie toutefois pas ignorer les risques. Cela signifie limiter les expériences de façon à ce que l’organisation puisse apprendre sans générer de conséquences incontrôlables.
Troisièmement : l’autonomie doit être liée à des preuves. Ce n’est pas l’appréciation générale « nous faisons désormais confiance au système » qui devrait décider d’un niveau d’autonomie supérieur. Ce qui compte, ce sont des preuves concrètes : pour quelle tâche les résultats sont-ils solides ? Dans quelles conditions ? Quelles erreurs sont détectées ? À quelle vitesse peut-on intervenir ou revenir en arrière ? Qui décide de la montée et de la descente de niveau ?
Quatrièmement : les processus d’ingénierie existants ne devraient pas être simplement étendus, mais examinés, voire repensés. L’introduction de l’IA est une occasion de se demander si les points de contrôle existants portent réellement sur les risques pertinents. Ajouter une approbation supplémentaire pour chaque action de l’IA à un processus de modification déjà surchargé n’augmente que la bureaucratie – pas la sécurité.
La confiance est le résultat de bonnes conditions
L’IA ne pourra déployer tout son potentiel en ingénierie que lorsque les entreprises lui offriront non seulement des tâches, mais aussi une marge de manœuvre appropriée. Cette marge de manœuvre ne doit naître ni de l’euphorie ni être bloquée par la peur.
Et : la confiance envers l’IA n’est pas un interrupteur marche/arrêt. Elle est spécifique à la tâche, basée sur l’observation et révocable. Elle croît lorsqu’une entreprise s’engage activement avec l’IA, apprend à connaître ses capacités et ses limites, et tire les conséquences de ses résultats.
Cela nécessite un bon contexte, des garde-fous clairs, des points de contrôle pertinents, des résultats visibles, une responsabilité clarifiée et une possibilité de rétrogradation qui fonctionne.
Qui ne fait que contrôler sans apprendre reste prisonnier d’un contrôle au détail. Qui ne fait que faire confiance sans observer confond espoir et gouvernance.
L’avenir de l’ingénierie ne réside donc ni dans le contrôle total de l’IA ni dans son autonomie totale. Il réside dans la capacité à lui donner une marge de manœuvre précisément là où les humains ont compris sa performance, ses limites et les conséquences d’une erreur.
Questions et réponses
Pourquoi l’IA en ingénierie a-t-elle besoin non seulement de règles, mais aussi de confiance ?
Parce qu’une IA ne déploie tout son potentiel que lorsqu’on lui confie une tâche et une marge de manœuvre. Qui fait approuver chaque action individuelle obtient finalement un système bien sécurisé – mais n’y gagne presque rien. La confiance n’est pas ici un crédit accordé d’avance, mais la volonté fondée de s’appuyer sur le système, dans l’incertitude, pour une tâche concrète.
Quelle est la différence entre la gouvernance de l’IA et les garde-fous ?
La gouvernance est le cadre organisationnel : qu’est-ce qui est permis, qui est responsable sur le fond, qui approuve, comment la supervision s’exerce-t-elle ? Les garde-fous traduisent une partie de ce cadre en restrictions techniques au moment de l’exécution – droits d’accès, seuils, passerelles API, logique de processus. Point décisif : une limite que l’agent peut lui-même dépasser n’est pas une limite. Les restrictions critiques doivent être appliquées en dehors du modèle.
Quelle autonomie une IA devrait-elle obtenir en PLM et en ingénierie ?
Autant que la tâche individuelle peut en supporter – l’autonomie est attribuée par tâche, pas de façon générale par modèle. Trois niveaux donnent une orientation : Proposer (l’IA produit des ébauches, les humains décident de leur usage), Préparer et informer (l’IA relie des informations et analyse des impacts, mais ne déclenche pas la décision) et Exécuter dans des limites strictes (l’IA agit elle-même lorsque l’étendue, l’accès aux données, la journalisation, la réversibilité et l’escalade sont réglés).
Comment évaluer le risque d’une tâche d’IA ?
À travers quatre questions issues de méthodes d’ingénierie établies. De l’AMDEC : la propagation (jusqu’où une erreur se répercute-t-elle dans le produit, le processus et l’organisation ?), la qualité du contexte (le système dispose-t-il des bonnes informations ?) et l’observabilité (l’erreur est-elle repérée avant de produire son effet ?). S’ajoute la maîtrisabilité issue de la sécurité fonctionnelle selon l’ISO 26262, ici comme réversibilité : l’action peut-elle être annulée dans tous les systèmes concernés ? Propagation et réversibilité ensemble donnent le rayon d’impact (blast radius) – et la supervision doit croître avec lui.
Le human-in-the-loop suffit-il comme supervision des systèmes d’IA ?
Non. Un humain dans le processus n’est pas encore une supervision efficace. Pour cela, cette personne doit recevoir les informations pertinentes, situer le résultat sur le fond, en évaluer les conséquences et pouvoir réellement intervenir. Si le temps, la compétence ou la possibilité de revenir en arrière manquent, on obtient du rubber-stamping – l’humain reste nominalement dans la boucle, mais devient un simple tampon. Un contrôle intégral de chaque action n’aide pas davantage : il crée une lassitude de validation, et donc exactement l’automation bias qu’il devait empêcher.
Qu’exige l’AI Act de l’UE pour la supervision humaine de l’IA ?
L’art. 14 n’exige pas, pour les systèmes d’IA à haut risque, que chaque calcul interne du modèle soit reconstituable. Il exige que les personnes chargées de la supervision comprennent de façon appropriée les capacités et les limites du système, répondent consciemment à l’automation bias et puissent situer, rejeter ou outrepasser les résultats. Le par. 3 exige d’aligner la supervision sur le risque, le degré d’autonomie et le contexte d’usage ; l’art. 26, par. 2 engage les exploitants à la confier à des personnes disposant de la compétence, de la formation et de l’autorité nécessaires.
Une gouvernance excessive peut-elle freiner l’usage de l’IA ?
Oui. Le MIT Center for Information Systems Research résume cela par minimum viable governance : autant de gouvernance que nécessaire pour limiter efficacement le risque. Au-delà de cette limite, elle freine plus qu’elle ne protège – les décisions s’accumulent, l’opportunité passe. Une gouvernance inadaptée favorise en outre le shadow AI : les collaborateurs se tournent vers la voie non officielle et soustraient ainsi l’usage au contrôle justement prévu.